面向 DeepSeek Harness Web 的 AI 音频插件 —— 多厂商 TTS、音乐、音效与音色设计,含侧边栏面板、模型对比、资源库与 Agent 工具。
安装
# npm 包(预构建)
dsh plugin --profile web add dsh-audiogen
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:shimingming520/dsh-audiogen
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
DeepSeek Harness(DSH)AI 音频插件 —— 让 DSH Web 变成一个音频工作台:文本转语音、音乐生成、音效生成、音色设计,侧边栏面板和 Agent 都能直接用。
✨ 功能特性
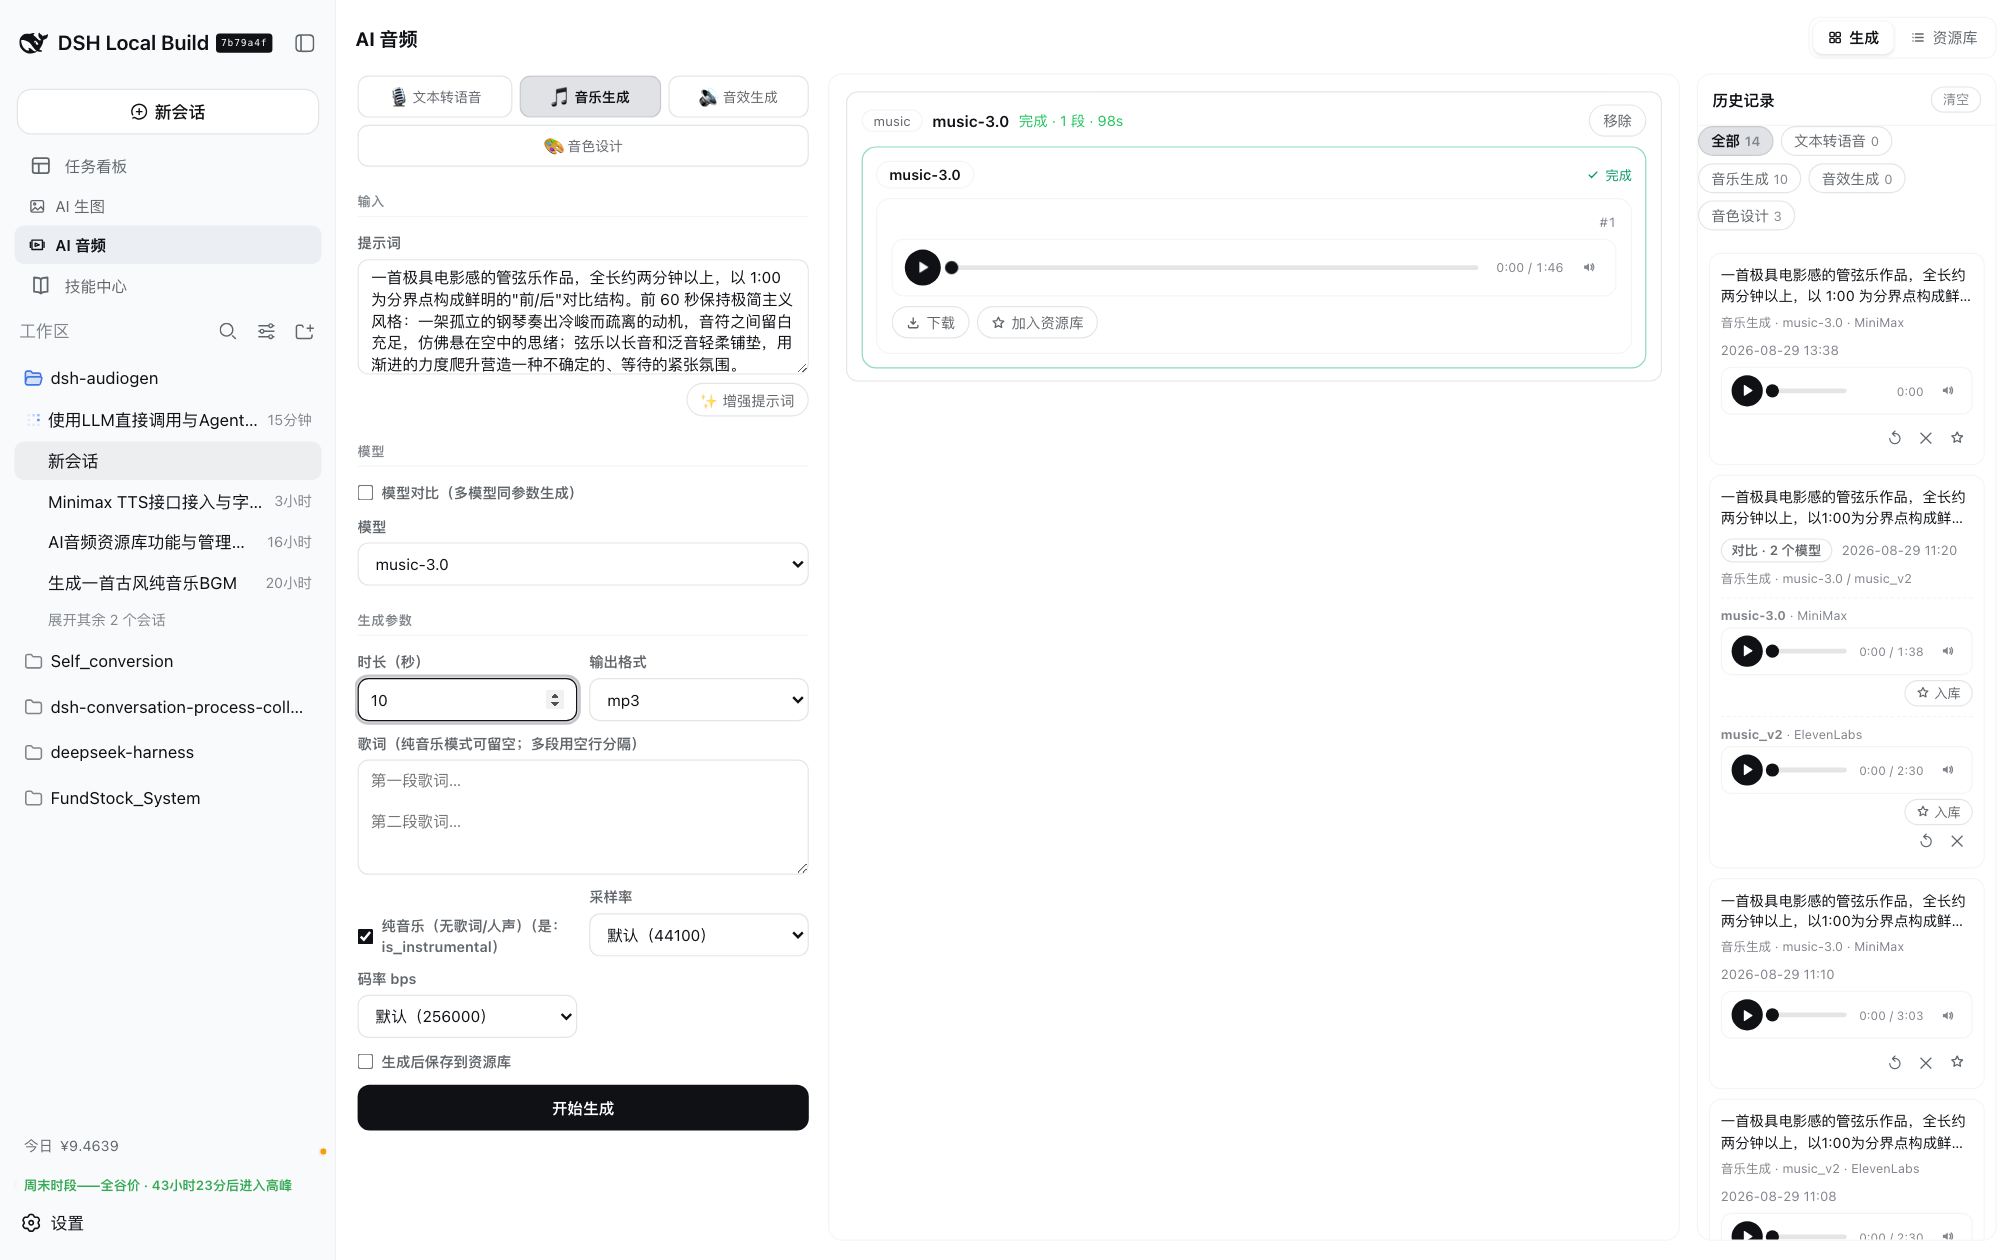
- 四种生成模式:文本转语音(TTS)· 音乐生成 · 音效生成 · 音色设计
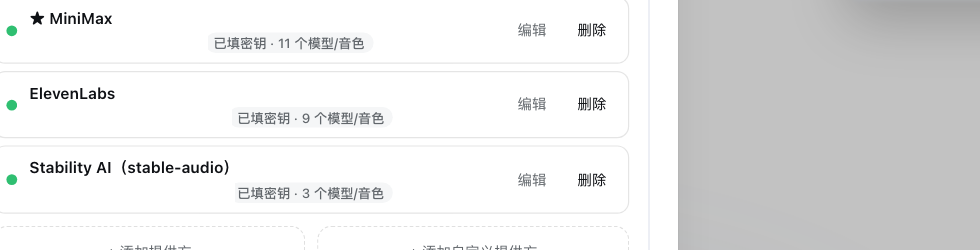
- 多厂商渠道统一管理:OpenAI 兼容 TTS、MiniMax、ElevenLabs、Stability AI,以及任意自定义 OpenAI 兼容 / 通用 POST 接口
- 每渠道模型/音色目录:一键「获取可用模型」、显示名称(alias)、能力分类(语音/音乐/音效/音色设计),按模型展示完整参数(时长、seed、steps、cfg_scale、loop、提示词影响度,ElevenLabs 音效输出格式拆为「格式/采样率/码率」三个参数、由引擎组合为
output_format……) - 模型对比:同一提示词并发生成 2–4 个模型,支持每模型参数覆盖,结果按模型分组并列对比
- ✨ 提示词增强:把一句粗略想法扩写成适合生成模型的完整描述,LLM 模型可在「设置 → 模型」中任选(缺省跟随 Agent 默认模型,无需额外 API Key)
- 历史记录一键恢复:prompt、配置、模型组合以及当时的音频全部回到面板——可直接试听/下载,无需重新生成、不额外消耗
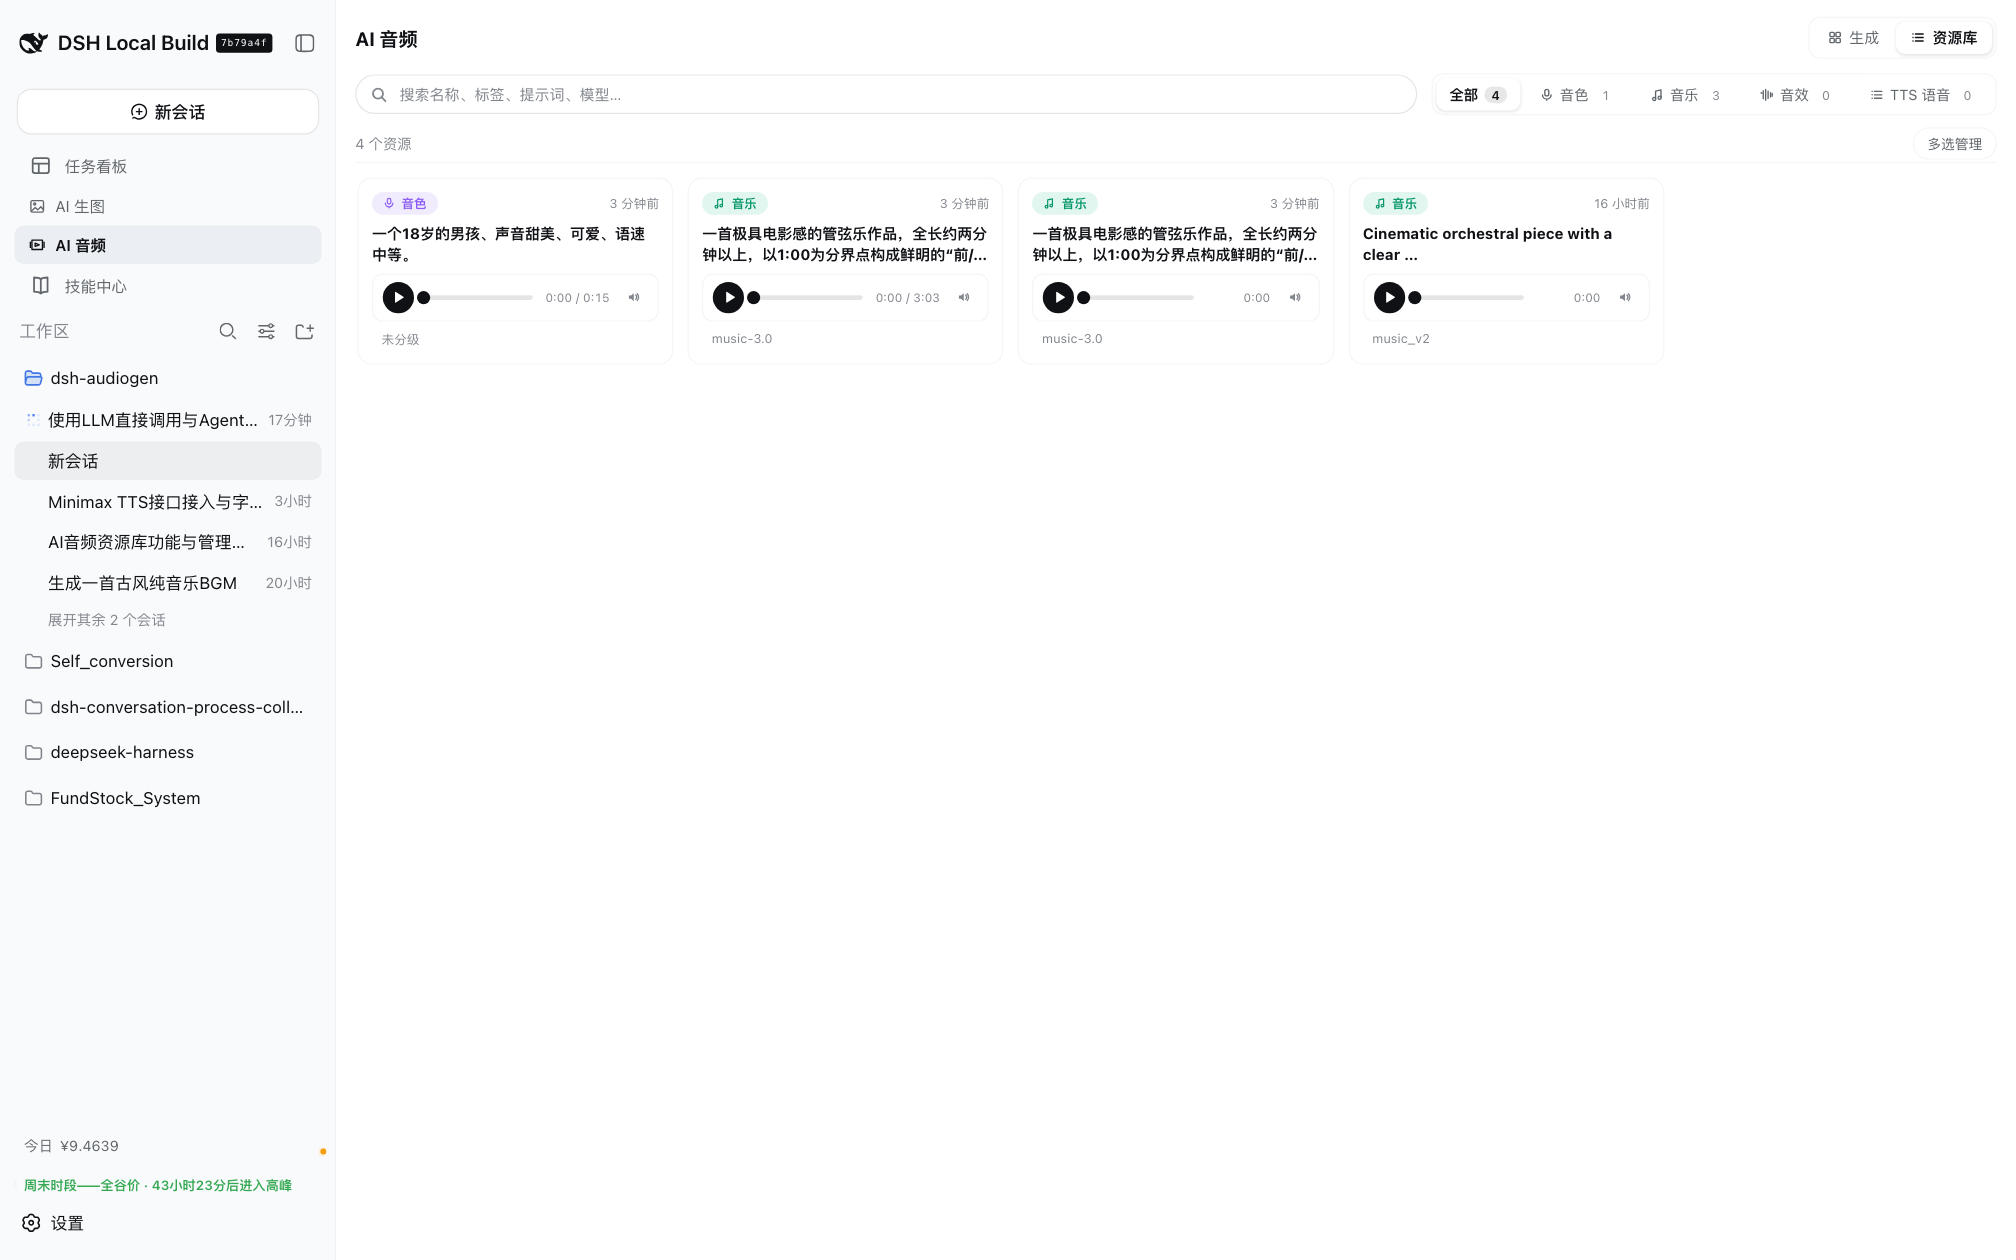
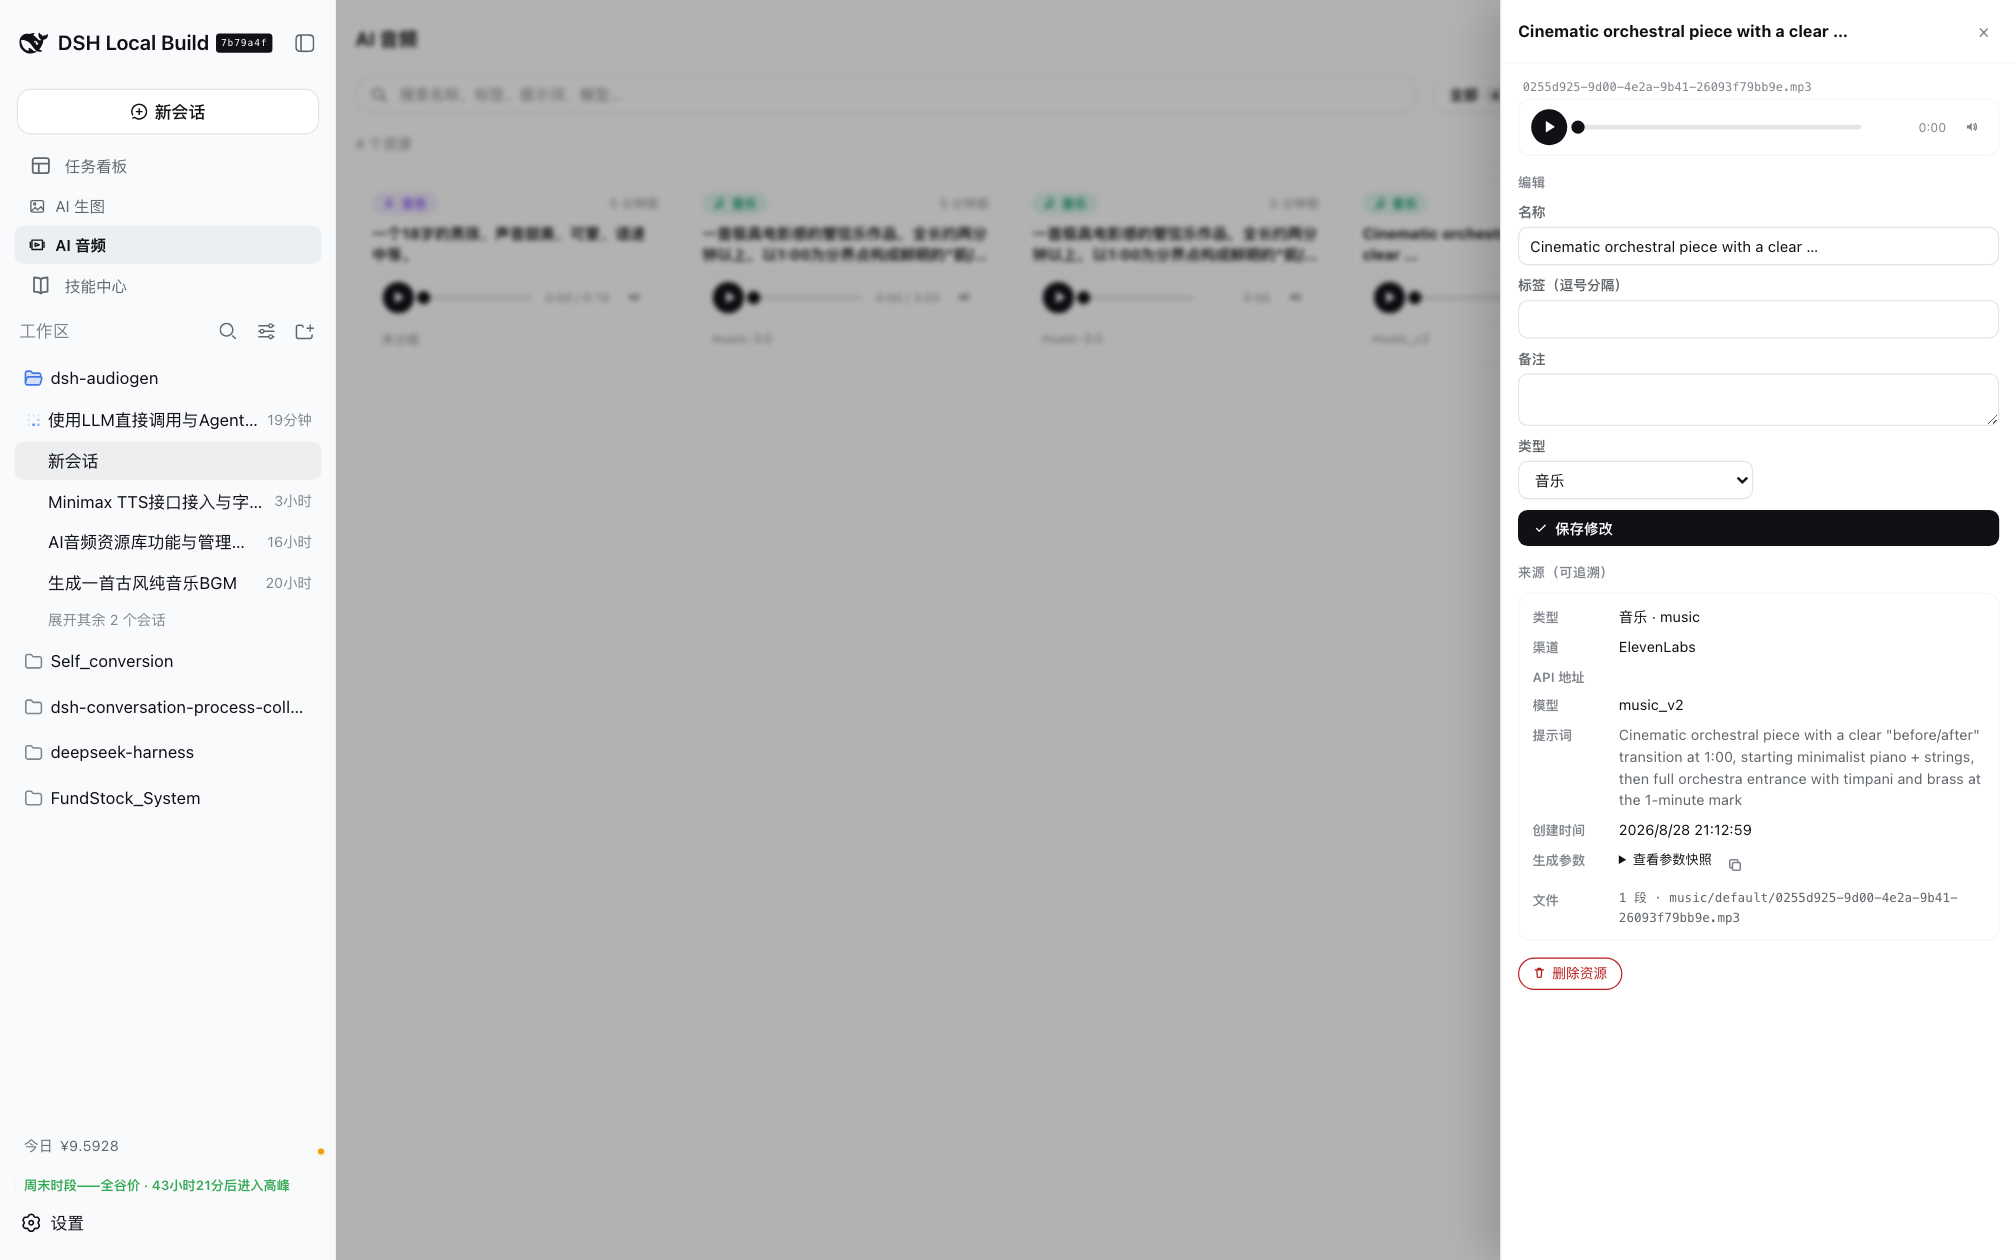
- 资源库:生成后可一键入库(或设置自动保存),按类型分目录——音色 voice / 音乐 music / 音效 sfx / TTS——支持搜索、标签、重命名、移动分类,并保留完整溯源(渠道、模型、voiceId、提示词、参数快照)。同款音色/配乐/音效直接复用,不必重复生成
- Agent 工具:
generate_audio、search_audio_library与manage_audio_voices(厂商音色浏览/删除 + 按需求描述推荐音色 + 角色音色选角 cast),并随包分发 TTS/音乐/音效/音色设计/选角会话技能 - 角色音色选角(casting):为小说/游戏配音逐角色分配主音色 + 备用音色——
manage_audio_voices的action=cast接收角色画像(JSON 数组/对象或文本整理后的 JSON),按性别/年龄/用途做确定性硬过滤(accent 为偏好、候选为空才放松)返回每角色候选池;Agent 在上下文中全局选角(lead/major 主音色不复用)后action=save_cast校验 voice_id 属于候选池、自动补齐备份、标记复用警告并持久化到~/.dsh/dsh-audiogen/cast-selections.json,随后按选定voice_id生成 TTS(也可先用generate_audio(mode=voice_design)为角色创作专属音色) - 面板音色管理:生成页左侧模式栏新增「音色」入口(与 TTS/音乐/音效/音色设计并列)— 浏览/筛选厂商音色(语言/关键词/来源 + ElevenLabs 官方共享库筛选)、按需求描述让 Agent 默认模型推荐音色(如「清亮甜美的少女音」)、试听、删除账户自建音色(需确认)、一键把选定
voice_id回填到 TTS 表单;每次 AI 推荐自动记录(最近 50 条,面板与 Agent 共用),可随时回看需求/渠道/推荐理由并直接复用 - 密钥留在本机:API 密钥存于本地 DSH 设置文档,生成请求由本地宿主代理转发,浏览器与 Agent 全程不接触明文密钥
📸 截图
| 生成面板 | 资源库 |
|---|---|
|
 |
| 资源库详情(完整溯源) | 渠道设置 |
|---|---|
 |
 |
| 渠道编辑(模型目录与自动能力识别) | LLM 模型(设置 → 模型) |
|---|---|
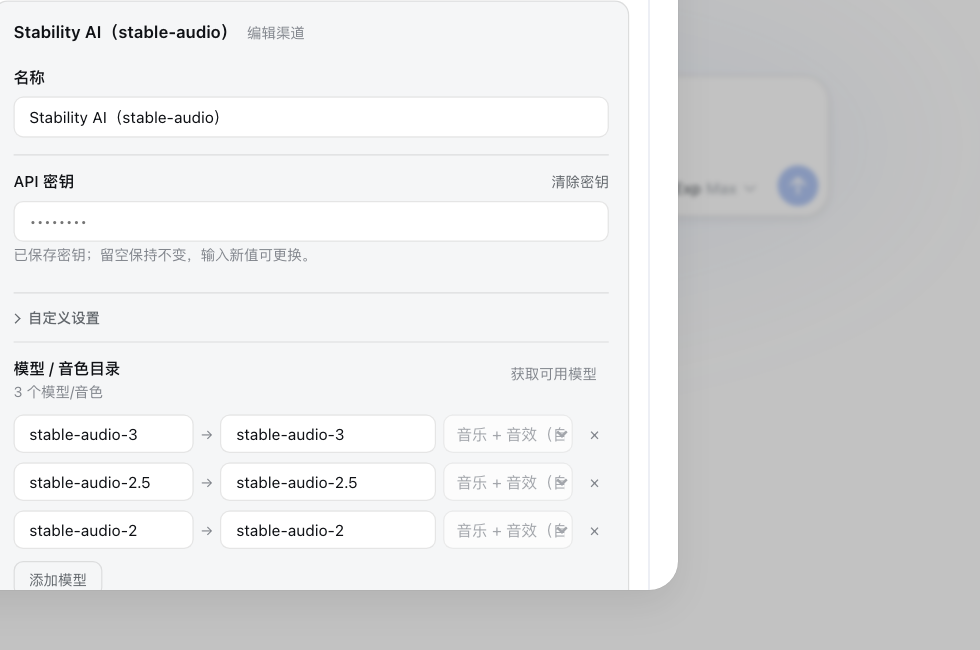 |
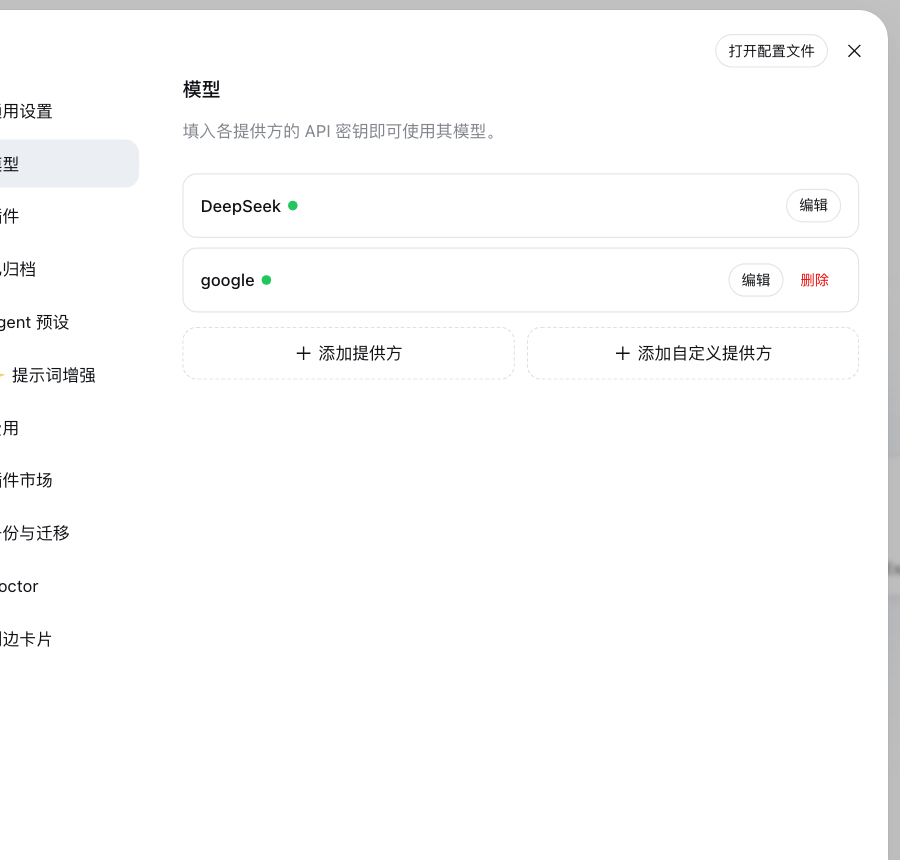 |
📦 安装
插件已发布到 npm,需要 DSH 宿主(Node ≥ 20):
dsh plugin --profile web add dsh-audiogen
本地开发安装:
dsh plugin --profile web add /path/to/dsh-audiogen
安装后重启 dsh web,侧边栏出现 AI 音频。
🚀 快速开始
- 打开 设置 → 插件 → AI 音频
- 添加渠道:选择预置提供方(+ 添加提供方)或自定义端点(+ 添加自定义提供方)
- 填写 API 地址、API 密钥与模型/音色目录(可用「获取可用模型」一键导入)
- 保存后打开侧边栏 AI 音频 面板:
- 选择模式(文本转语音 / 音乐生成 / 音效生成 / 音色设计)
- 输入文本或提示词(可选:✨ 增强提示词)
- 选择模型;或勾选「模型对比」一次生成 2–4 个模型
- 点击 开始生成,试听、下载,或一键加入资源库
🎛 各厂商支持的模式
| 模式 | MiniMax | ElevenLabs | Stability AI | OpenAI 兼容 / 自定义 |
|---|---|---|---|---|
| TTS | ✅(8 种音色) | ✅(音色 + 流式) | — | ✅ |
| 音乐 | ✅(music-3.0 / music-2.6 / music-cover) |
✅(music_v2) |
✅(stable-audio-*) |
✅(通用 POST) |
| 音效 | — | ✅(eleven_text_to_sound_v2,loop / prompt_influence / 输出格式 格式+采样率+码率 → output_format) |
✅(stable-audio-*,同一 text-to-audio 协议,自动识别为音乐+音效双模式) |
✅(通用 POST) |
| 音色设计 | ✅(/v1/voice_design) |
✅(/v1/text-to-voice/design) |
— | — |
🤖 Agent 使用
| 工具 | 用途 |
|---|---|
generate_audio |
提交 TTS / 音乐 / 音效 / 音色设计任务,等待完成后返回同源音频 URL;支持 enhance_prompt、save_to_library 与各厂商参数。 |
manage_audio_voices |
浏览/筛选厂商音色库(MiniMax、ElevenLabs,支持语言/关键词/来源筛选);按需求描述推荐音色(action=recommend,复用 Agent 默认模型,返回音色 + 推荐理由,voice_id 校验为候选池真实成员);角色选角(action=cast 传角色画像 → 按性别/年龄/用途硬过滤出每角色候选池,action=save_cast 校验落盘);删除账户自有音色(官方/共享/系统音色只读并拒绝);随后把返回的 voice_id 交给 generate_audio(mode=tts)即可生成。 |
search_audio_library |
检索本地资源库(类型/分类/关键词),复用已有音色、配乐或音效。 |
会话内常用指令(插件自带技能):
/audio:tts 用温暖的声音朗读这句话
/audio:music 生成一段 30 秒的 Lo-fi 背景音乐
/audio:sfx 生成一声科幻风格的 UI 提示音
/audio:design 一个温暖复古的合成器音色
🔐 安全与数据说明
- API 密钥存于本地 DSH 设置文档;生成请求由本地宿主代理转发(
/api/dsh-audiogen/*,仅回环地址可访问) - 生成会消耗上游 API 额度;音频内容由上游模型生成
- 历史与资源库持久化在
~/.dsh/dsh-audiogen/ - 提示词增强使用所选 LLM 模型(默认跟随 Agent 默认模型),无需额外 API Key
🛠 开发
pnpm install
pnpm run typecheck
pnpm run build      # 输出 lib/(宿主 + 浏览器 bundle)
📄 许可证
链接
同类插件
PolinniZhong/dsh-omi-voice★ 75
DeepSeek Harness 对话内朗读:点一下即可朗读、暂停、继续 AI 回复,豆包 TTS 自然音色(BYOK),只读最终回答并过滤代码、表格与图形,本地引擎,插件零 Key。
PensiveFei/dsh-voice-scribe★ 36
面向 Web UI 的语音输入插件:点按 Alt(或 Alt+空格)开始/停止听写,支持浏览器内置 Web Speech(零配置)或 OpenAI 兼容云端 ASR,可选经 DSH 已配置模型润色,带设置页。
1624318455/dsh-plugin-tts★ 25
用免费 Edge TTS 或你自己的 RVC 音色朗读 AI 回复:消息朗读与自动朗读、长文自适应分块渐进播放(无缝衔接)、音色包仓库一键安装、便携 RVC 运行时。
WizisCool/dsh-ears★ 22
面向 DeepSeek Harness (dsh) 的语音输入插件:输入框的麦克风按钮把语音转成草稿文本,支持多种语音识别后端,可选经 dsh 自有 LLM 路由润色,并带原生设置页。
ppy-web/dsh-plugin-xiaomi-mimo-tts★ 18
为 DSH Web 添加 Xiaomi MiMo 语音朗读,支持助手消息朗读、PCM 流式播放、预置与自定义音色、浏览器语音兜底、播放控制和可选 UI 音效。
PerryLink/dsh-talk★ 17
DeepSeek Harness 的语音输入输出:麦克风语音转文字与文字转语音。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。