用 DeepSeek 网页端自带的朗读,把 DSH 里的对话念出来,靠一个小浏览器扩展驱动。
安装
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:Yuuyuko-uu/dsh-tts-bridge
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
🐳 朗读桥
让 DSH 里的会话,用 DeepSeek 网页端的声音念出来。
大肥鱼说了一句话 → 自动发到 DeepSeek 网页端让它复述 → 用你自己账号的朗读功能出声。 声音从你的电脑里出来,你不用盯着那个页面。
名字里的「桥」就是这个意思:DSH 这边知道说了什么,浏览器那边负责让声音出来,中间靠它接起来。
它由两部分组成(缺一不可)
| 是什么 | 干什么 | |
|---|---|---|
① DSH 插件 dsh-tts-bridge |
住在 DSH 里 | 盯着你选的会话,把「说完一整轮」的话排进队列 |
| ② 浏览器扩展 「朗读桥」 | 住在 Chrome / Edge 里 | 取走队列里的话,发给 DeepSeek,点它的「朗读」按钮 |
需要什么
- DSH(DeepSeek Harness),带 Web 界面
- Chromium 内核的浏览器:Chrome / Edge / Brave 等(Firefox 不行)
- 一个你自己的 DeepSeek 账号(朗读是它给每个账号的功能)
- 用的时候,那个 DeepSeek 页面要开着(真正出声的是它)
装法
第一步:装 DSH 插件
dsh plugin --profile web add dsh-tts-bridge
装完重启一次 DSH。
重启后,DSH 窗口右下角会出现一张小卡片 🐳 朗读桥。
第二步:装浏览器扩展
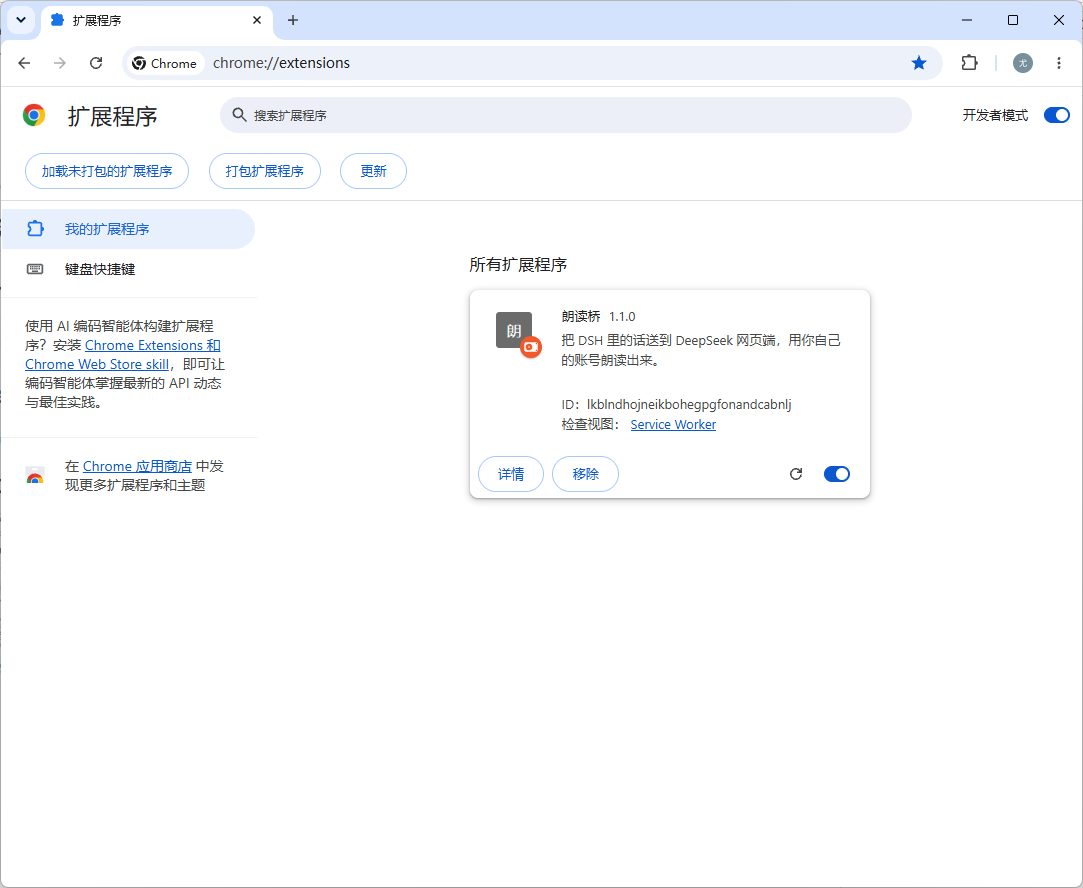
- 打开
chrome://extensions(Edge 用edge://extensions) - 打开「开发者模式」(Chrome 在右上角,Edge 在左下角)
- 点「加载已解压的扩展程序」,选中
extension/这个文件夹 - 打开 https://chat.deepseek.com 并登录你自己的账号
- 这个页面左下角会出现一行状态字 —— 装好了
Chrome 每次启动可能提醒一句「请停用开发者模式扩展」,点保留或关掉都行,不影响使用。
extension/这个文件夹在哪?它就在插件的安装目录里,不用去 GitHub 下:
- 网页版(npx):
%USERPROFILE%\.dsh\profiles\web\node_modules\dsh-tts-bridge\extension- 桌面版:
%APPDATA%\dsh-desktop\harness\profiles\web\node_modules\dsh-tts-bridge\extension(把上面那行整个复制到资源管理器的地址栏,回车就跳过去了。如果朗读桥的卡片提示「还差一步」,说明就是这一步没做。)
第三步:第一次先自己点一下朗读(必做)
浏览器不信任「程序点的按钮」,只信任真人点的。所以第一次用之前:
- 在 DeepSeek 那个页面里,用鼠标点一下它自己的「朗读」按钮(随便点一下页面也行)
- 之后就一直能出声了 —— 自动念、点我们的 ▶,都不用再点
(这是浏览器定的规矩,绕不过去。哪天又不出声了,再真点一下就好。)
怎么用
每条回复下面三个键
| 键 | 作用 |
|---|---|
| ▶ 朗读 | 让 DeepSeek 念这一条(哪一条都行,不用是最新的) |
| ⏸ 停止 | 停 |
| ♡ 收藏 | 把这一条记下来(再点一下取消) |
DSH 右下角的小卡片 🐳 朗读桥
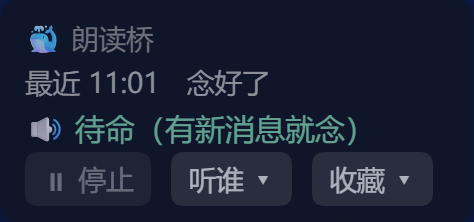
| ⏸ 停止 | 一键停 —— 不管声音是从哪儿念出来的 |
| 听谁 ▾ | 勾选要听哪些对话(默认一个都不听,自己勾;可以勾多个) |
| 收藏 ▾ | 分区收藏:点句子重念、⇄ 换分区、✕ 删掉;最下面能导出成 markdown |
| 按住状态行 0.6 秒 | 开关「自动朗读」 |
- 自动朗读开着时,你选的会话里每说完一整轮,就自动念出来
- 卡片整张按住就能拖,位置记得住
- 状态行会写它现在在干嘛:
待命/已发给 DeepSeek,等它复述…/正在出声…
只列「开着的」对话
「听谁」里只能勾当前载入着的会话 —— 插件只能读被载入的会话。 归档的对话会自动从清单里去掉,也不再听。
数据在哪
<DSH_HOME>/.dsh/tts-bridge.json
「听谁」和「收藏」都在里面,重启不丢。
常见问题
| 现象 | 原因 / 怎么办 |
|---|---|
| 点了朗读,图标在转但没声音 | 在这个页面真点一下(点它自己的「朗读」按钮),再点我们的 ▶ |
| 卡片不见了 | DSH 插件没跑起来 → 重启 DSH |
| 一直卡在「等它复述」 | 把 DeepSeek 那个页面按 F5 |
| 它自己弹了个 DeepSeek 窗口出来 | 这是「自愈」:页面不在、而队列里又有话,它就自己叫回来 |
| 念出来的话不是你要的 | 插件认的是「末尾那条回复」;如果页面上正好有别的变化,按 F5 再试 |
兼容性
| 浏览器 | |
|---|---|
| Chrome / Edge / Brave 等 Chromium 内核 | ✅ 可用(Edge 实测通过) |
| Firefox | ❌ 扩展机制不同,需要另写一版 |
关于合规(请读一下)
- 它不碰 DeepSeek 的接口、不提取音频、不存任何凭证。 扩展做的事,就是在你自己登录的浏览器里,替你点一下「朗读」按钮 —— 跟你手动点是一样的动作。
- 每个人用自己的账号,插件里不存账号也不存 cookie。
- 如果你把它的效果发到公开平台(视频、截图),里面出现 DeepSeek 生成的内容时, 请按平台和 DeepSeek 用户协议的要求标明「内容由 AI 生成」。
- 请不要在插件名、图标或宣传里使用「DeepSeek」「深度求索」的商标和 logo,也不要做得像官方出品。
- 朗读有每日限额,用得太猛会被限。
(本项目与深度求索公司无关,非官方工具。)
许可
MIT
链接
同类插件
PolinniZhong/dsh-omi-voice★ 73
DeepSeek Harness 对话内朗读:点一下即可朗读、暂停、继续 AI 回复,豆包 TTS 自然音色(BYOK),只读最终回答并过滤代码、表格与图形,本地引擎,插件零 Key。
PensiveFei/dsh-voice-scribe★ 33
面向 Web UI 的语音输入插件:点按 Alt(或 Alt+空格)开始/停止听写,支持浏览器内置 Web Speech(零配置)或 OpenAI 兼容云端 ASR,可选经 DSH 已配置模型润色,带设置页。
WizisCool/dsh-ears★ 20
面向 DeepSeek Harness (dsh) 的语音输入插件:输入框的麦克风按钮把语音转成草稿文本,支持多种语音识别后端,可选经 dsh 自有 LLM 路由润色,并带原生设置页。
1624318455/dsh-plugin-tts★ 18
用免费 Edge TTS 或你自己的 RVC 音色朗读 AI 回复:消息朗读与自动朗读、长文自适应分块渐进播放(无缝衔接)、音色包仓库一键安装、便携 RVC 运行时。
qishuilalala/dsh-voice-mode#dsh-voice-mode★ 12
DeepSeek Harness Web UI 全双工语音对话:按钮或 Ctrl+Shift+V 进入,持续聆听(停顿自动发送)或按住说话,zipformer2 流式识别入可编辑草稿、可选唤醒词;回复按句 Edge TTS 朗读并显示实时字幕,开口即打断播放与回合(真 barge-in);识别模型本地推理、Edge TTS 在线合成,无需 API Key。
Alan2Z/dsh-speak★ 11
零外部依赖、事件驱动、无需额外模型、不消耗任何 token的语音播报插件。使用系统自带自然语音进行播报,支持win/mac双平台;最终回复、审批与提问提醒、可选事件播报(回合结束/命令完成/目标变更/工具出错/待办更新)、最终回复可重播、双语言可视化设置。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。