在 DSH 聊天窗口自动调用生图工具(API 渠道,或本机 CLI:已支持 mmx / codex / agy)并展示图片,也支持利用对应 CLI 识别图片。
安装
# npm 包(预构建)
dsh plugin --profile web add dsh-chat-imagine
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:corrinehu/dsh-chat-imagine
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
English | 中文
实现了在 DeepSeek Harness(DSH) 的聊天窗口中自动调用生图工具(API 渠道,或本机 CLI:已支持mmx / codex / agy)并展示图片,也支持利用对应 CLI 识别图片。
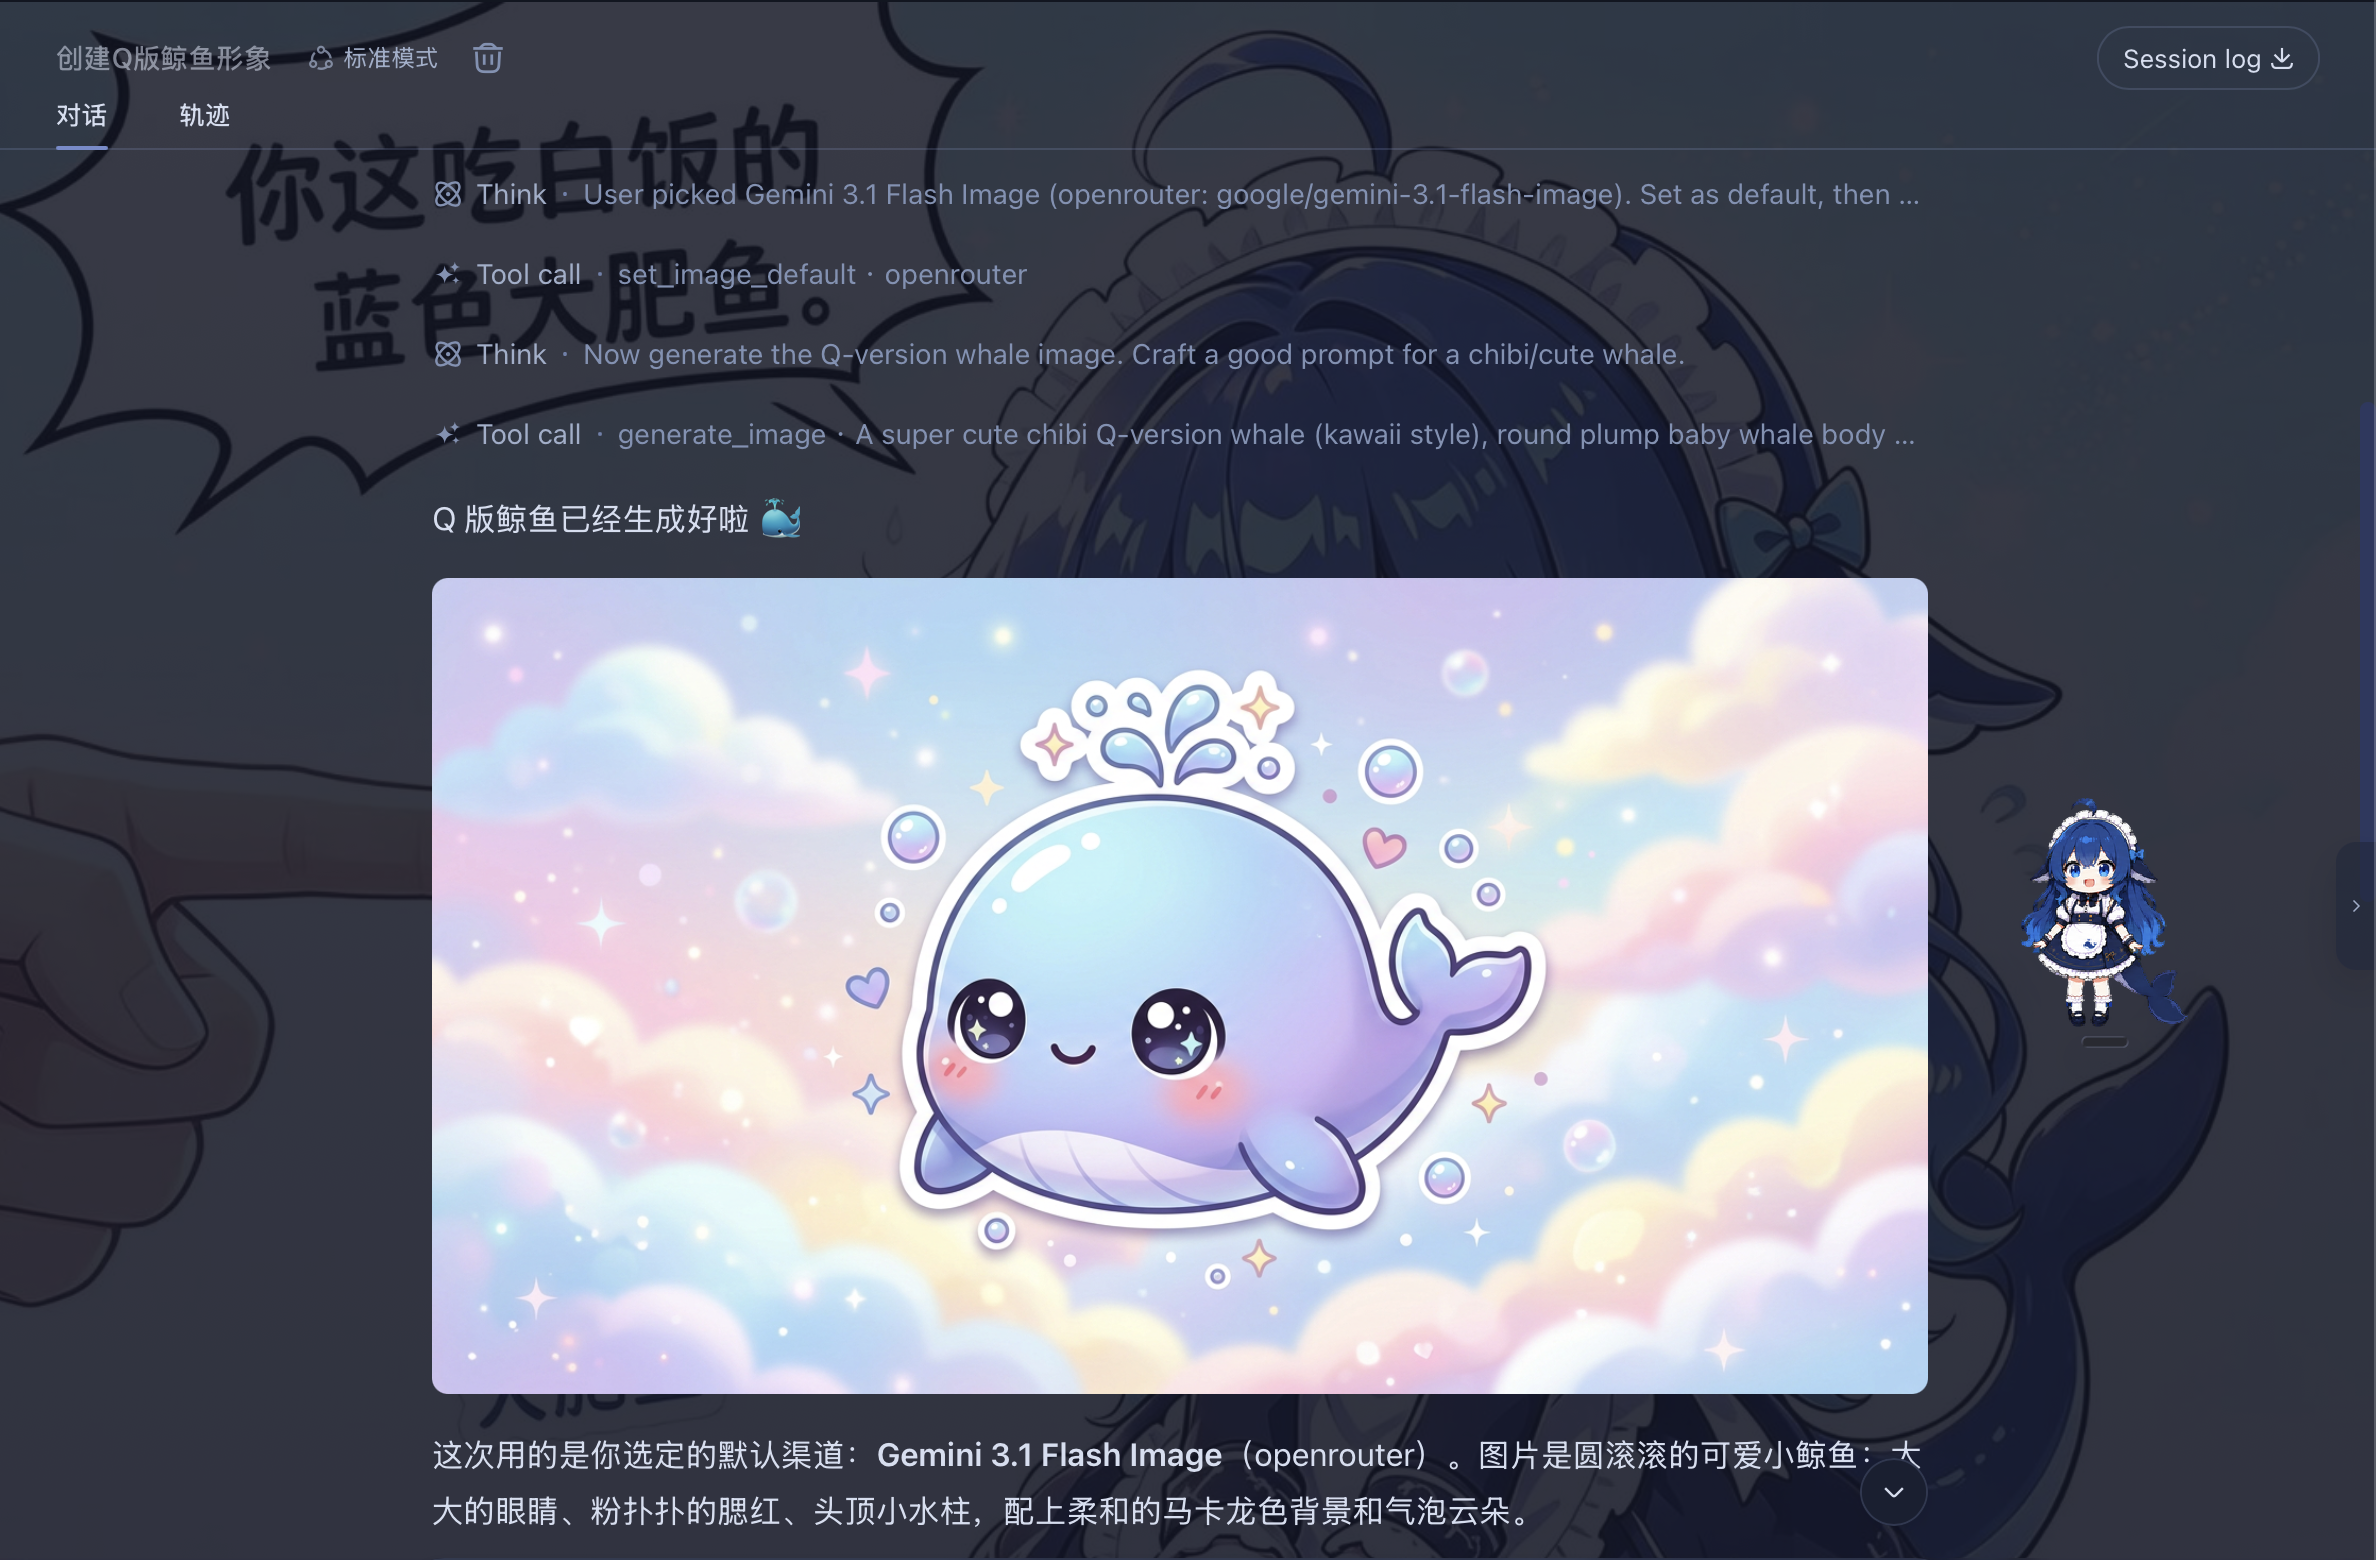
说明
支持 API 和 CLI 两种方式:
API
使用 DSH 中已配置的 OpenAI 兼容接口,从中查找可用的生图模型。
内置渠道(如 OpenRouter)在 DSH 设置里未填写 base URL 时,插件会自动使用 DSH 内置的默认地址,与聊天路由的行为一致。
CLI
插件会扫描本机是否安装了 MiniMax CLI(mmx)、OpenAI Codex CLI(codex)、Google Antigravity CLI(agy);找到的都会作为可用的生成图片和识别图片的渠道。
生成图片
- 调用
codex消耗的是 ChatGPT 账号(Plus/Pro)额度,而非 API key;需已安装 codex CLI,并登录有生图额度的账号(codex login status可查)。 - 调用
agy消耗的是 Google 账号额度;需已安装 agy CLI,并在 Antigravity App 里保持登录。 - 探测到 codex / agy 时,插件还会随包注册技能
cli-image-gen,教模型在generate_image工具失败(额度/区域限制/解析失败)时驱动 CLI 生图,以及收尾用show_image_file内联展示。
识别图片
- 识别走的是同一个 CLI 渠道的视觉能力(
mmx的 vision describe /codex的exec -i附图 + 服务端 JSON schema /agy的--json-schema),所以装了 mmx / codex / agy 任意一个即可识图,无需全装;一个都没装时插件照常工作,只是analyze_image会返回「未发现 CLI,不支持识图」。 - 把图片(本地路径或 http(s) URL)读取成结构化 JSON 证据:OCR 全文与逐行文本、按阅读顺序的版面区域、语义实体与关系、视觉线索、不确定项清单:任何模型(含纯文本模型)都能直接调用,无需切换到视觉模型。
- 渠道自动按速度选(
mmx→codex→agy),也可用set_image_default的visionBackend参数固定默认识图渠道。
安装
# npm(推荐,自带预构建产物)
dsh plugin --profile web add dsh-chat-imagine

# 或从 GitHub 源码安装
dsh plugin --profile web add github:corrinehu/dsh-chat-imagine
使用
安装启用插件后,在新对话里直接说你想画什么,例如:
帮我生成一个 Q 版蓝鲸 Logo
插件会检索可用的渠道和模型,并询问默认生图的渠道:
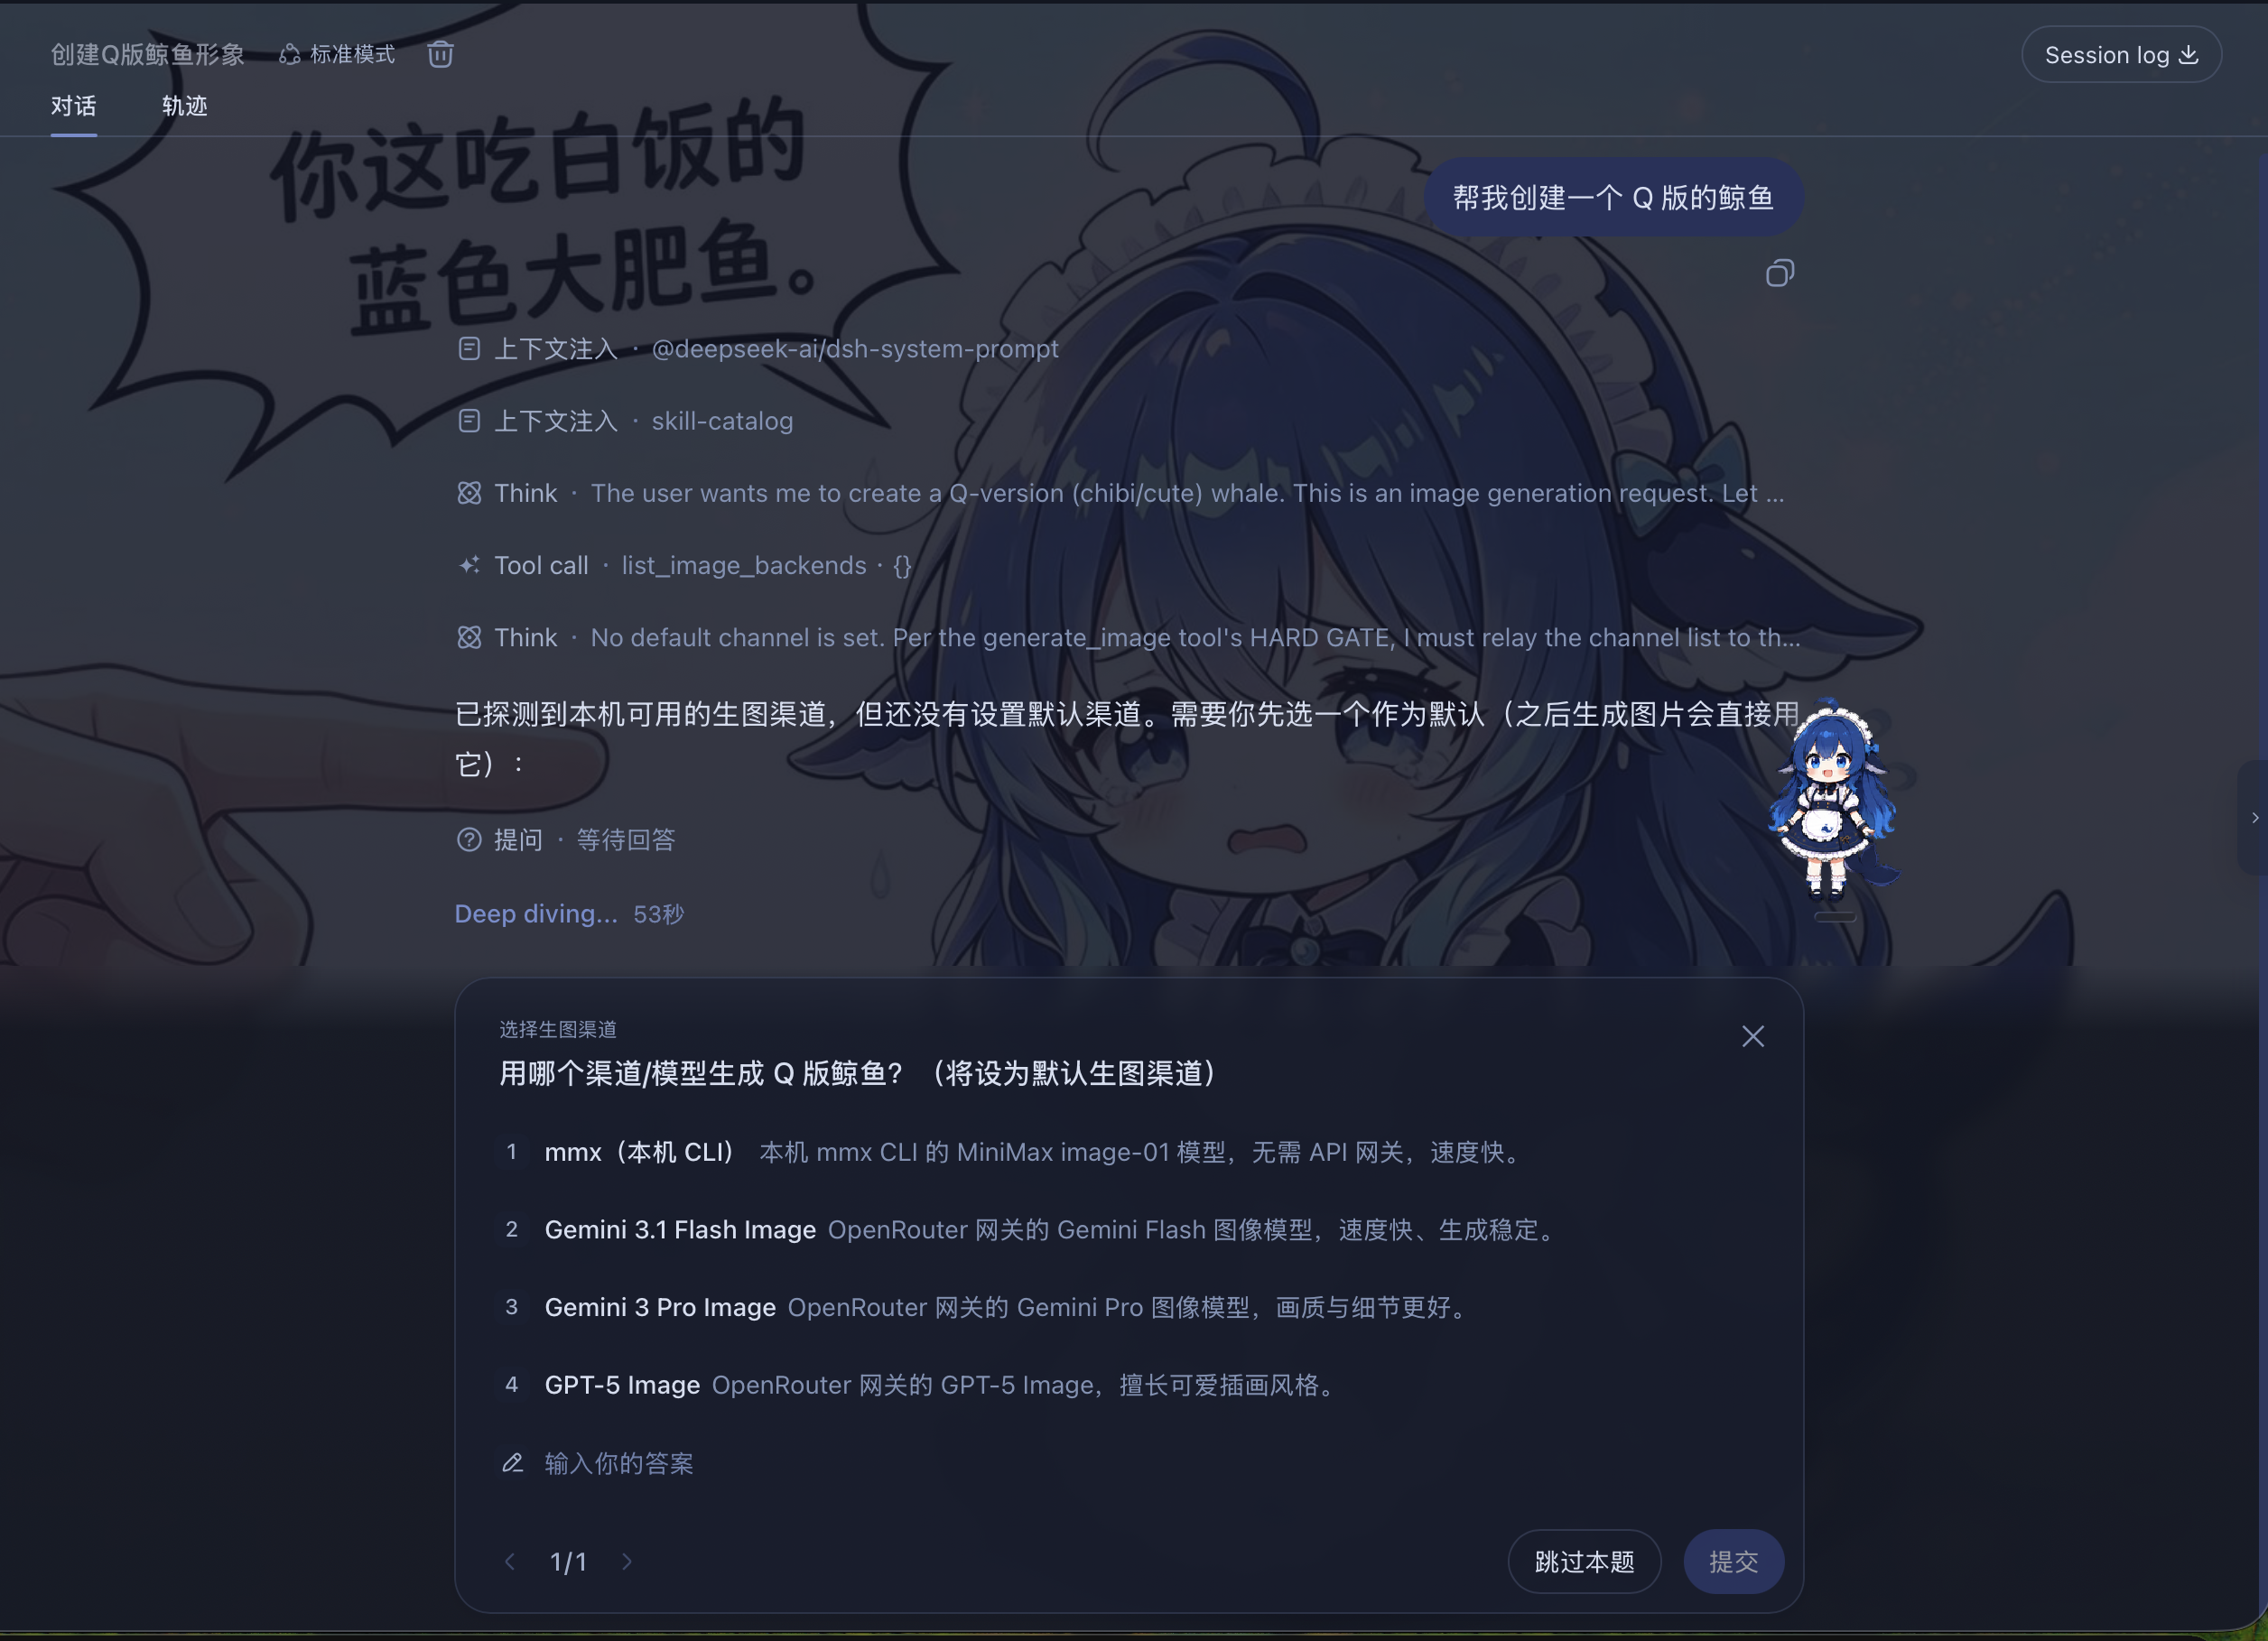
设置后,不必重复选择。之后,直接在聊天里描述你想要的图片:
生成一张 16:9 的雪山日出
生成结果会直接显示在聊天中。
也可使用其他生图渠道:
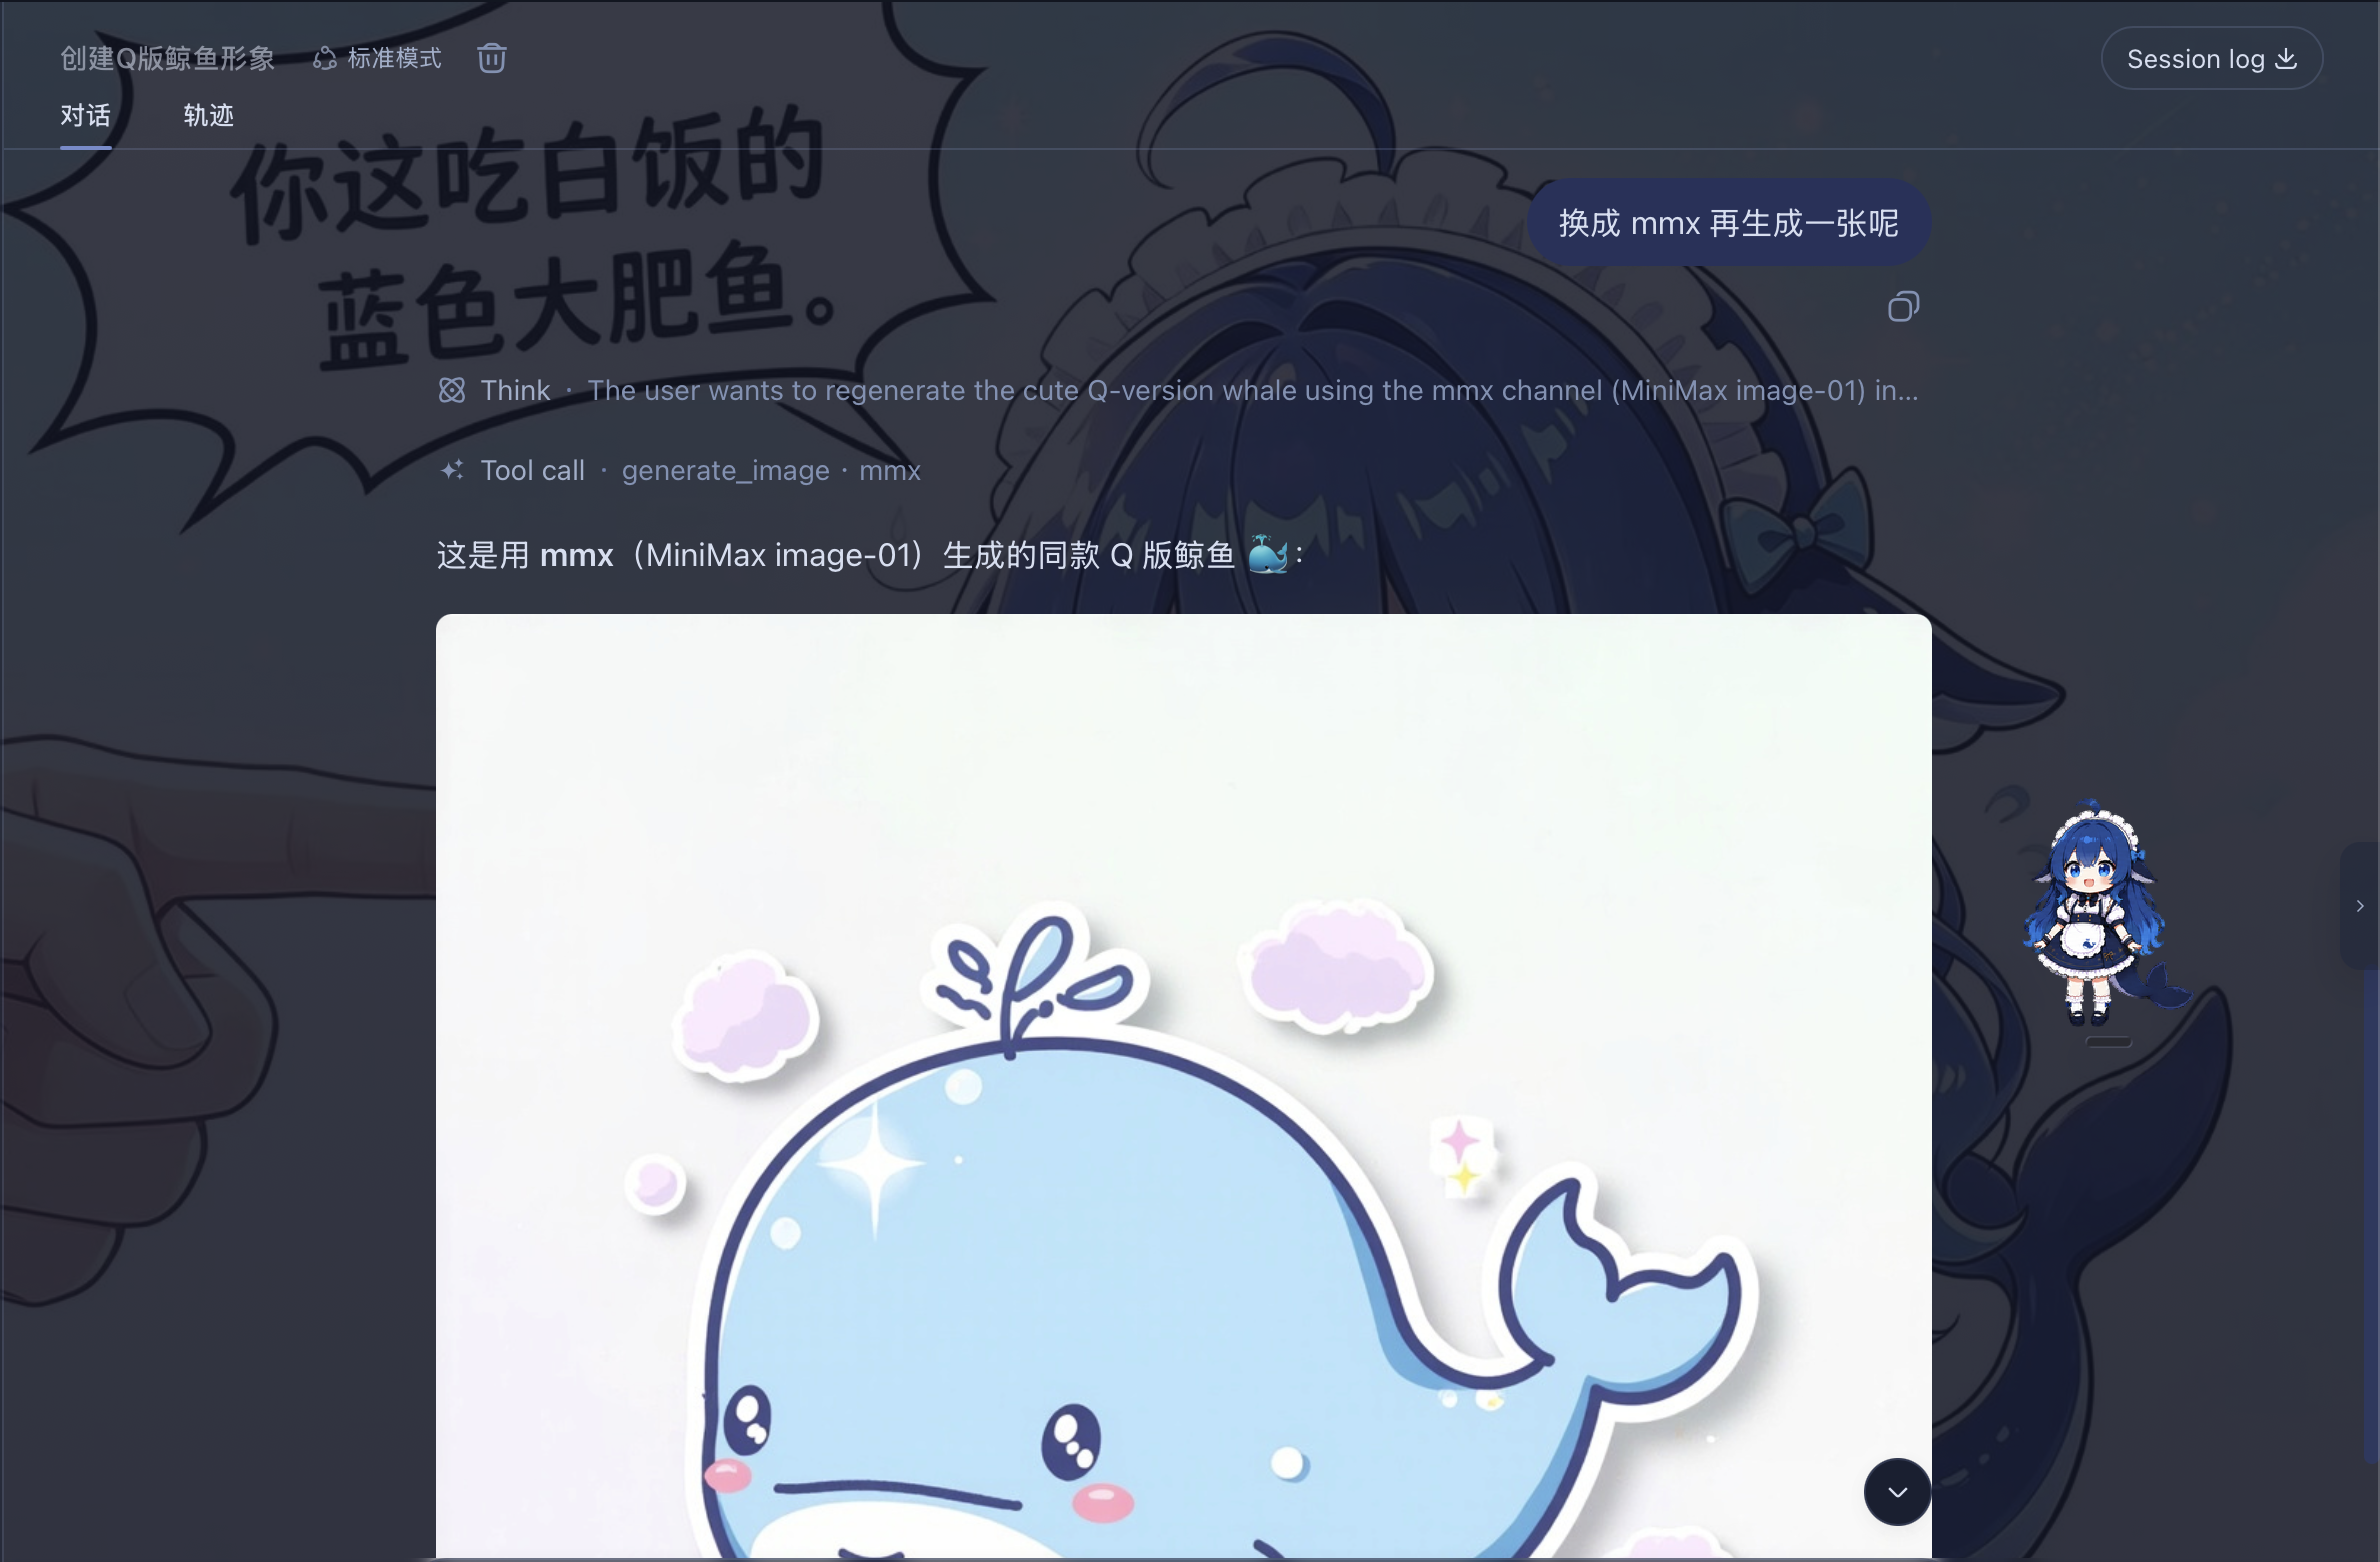
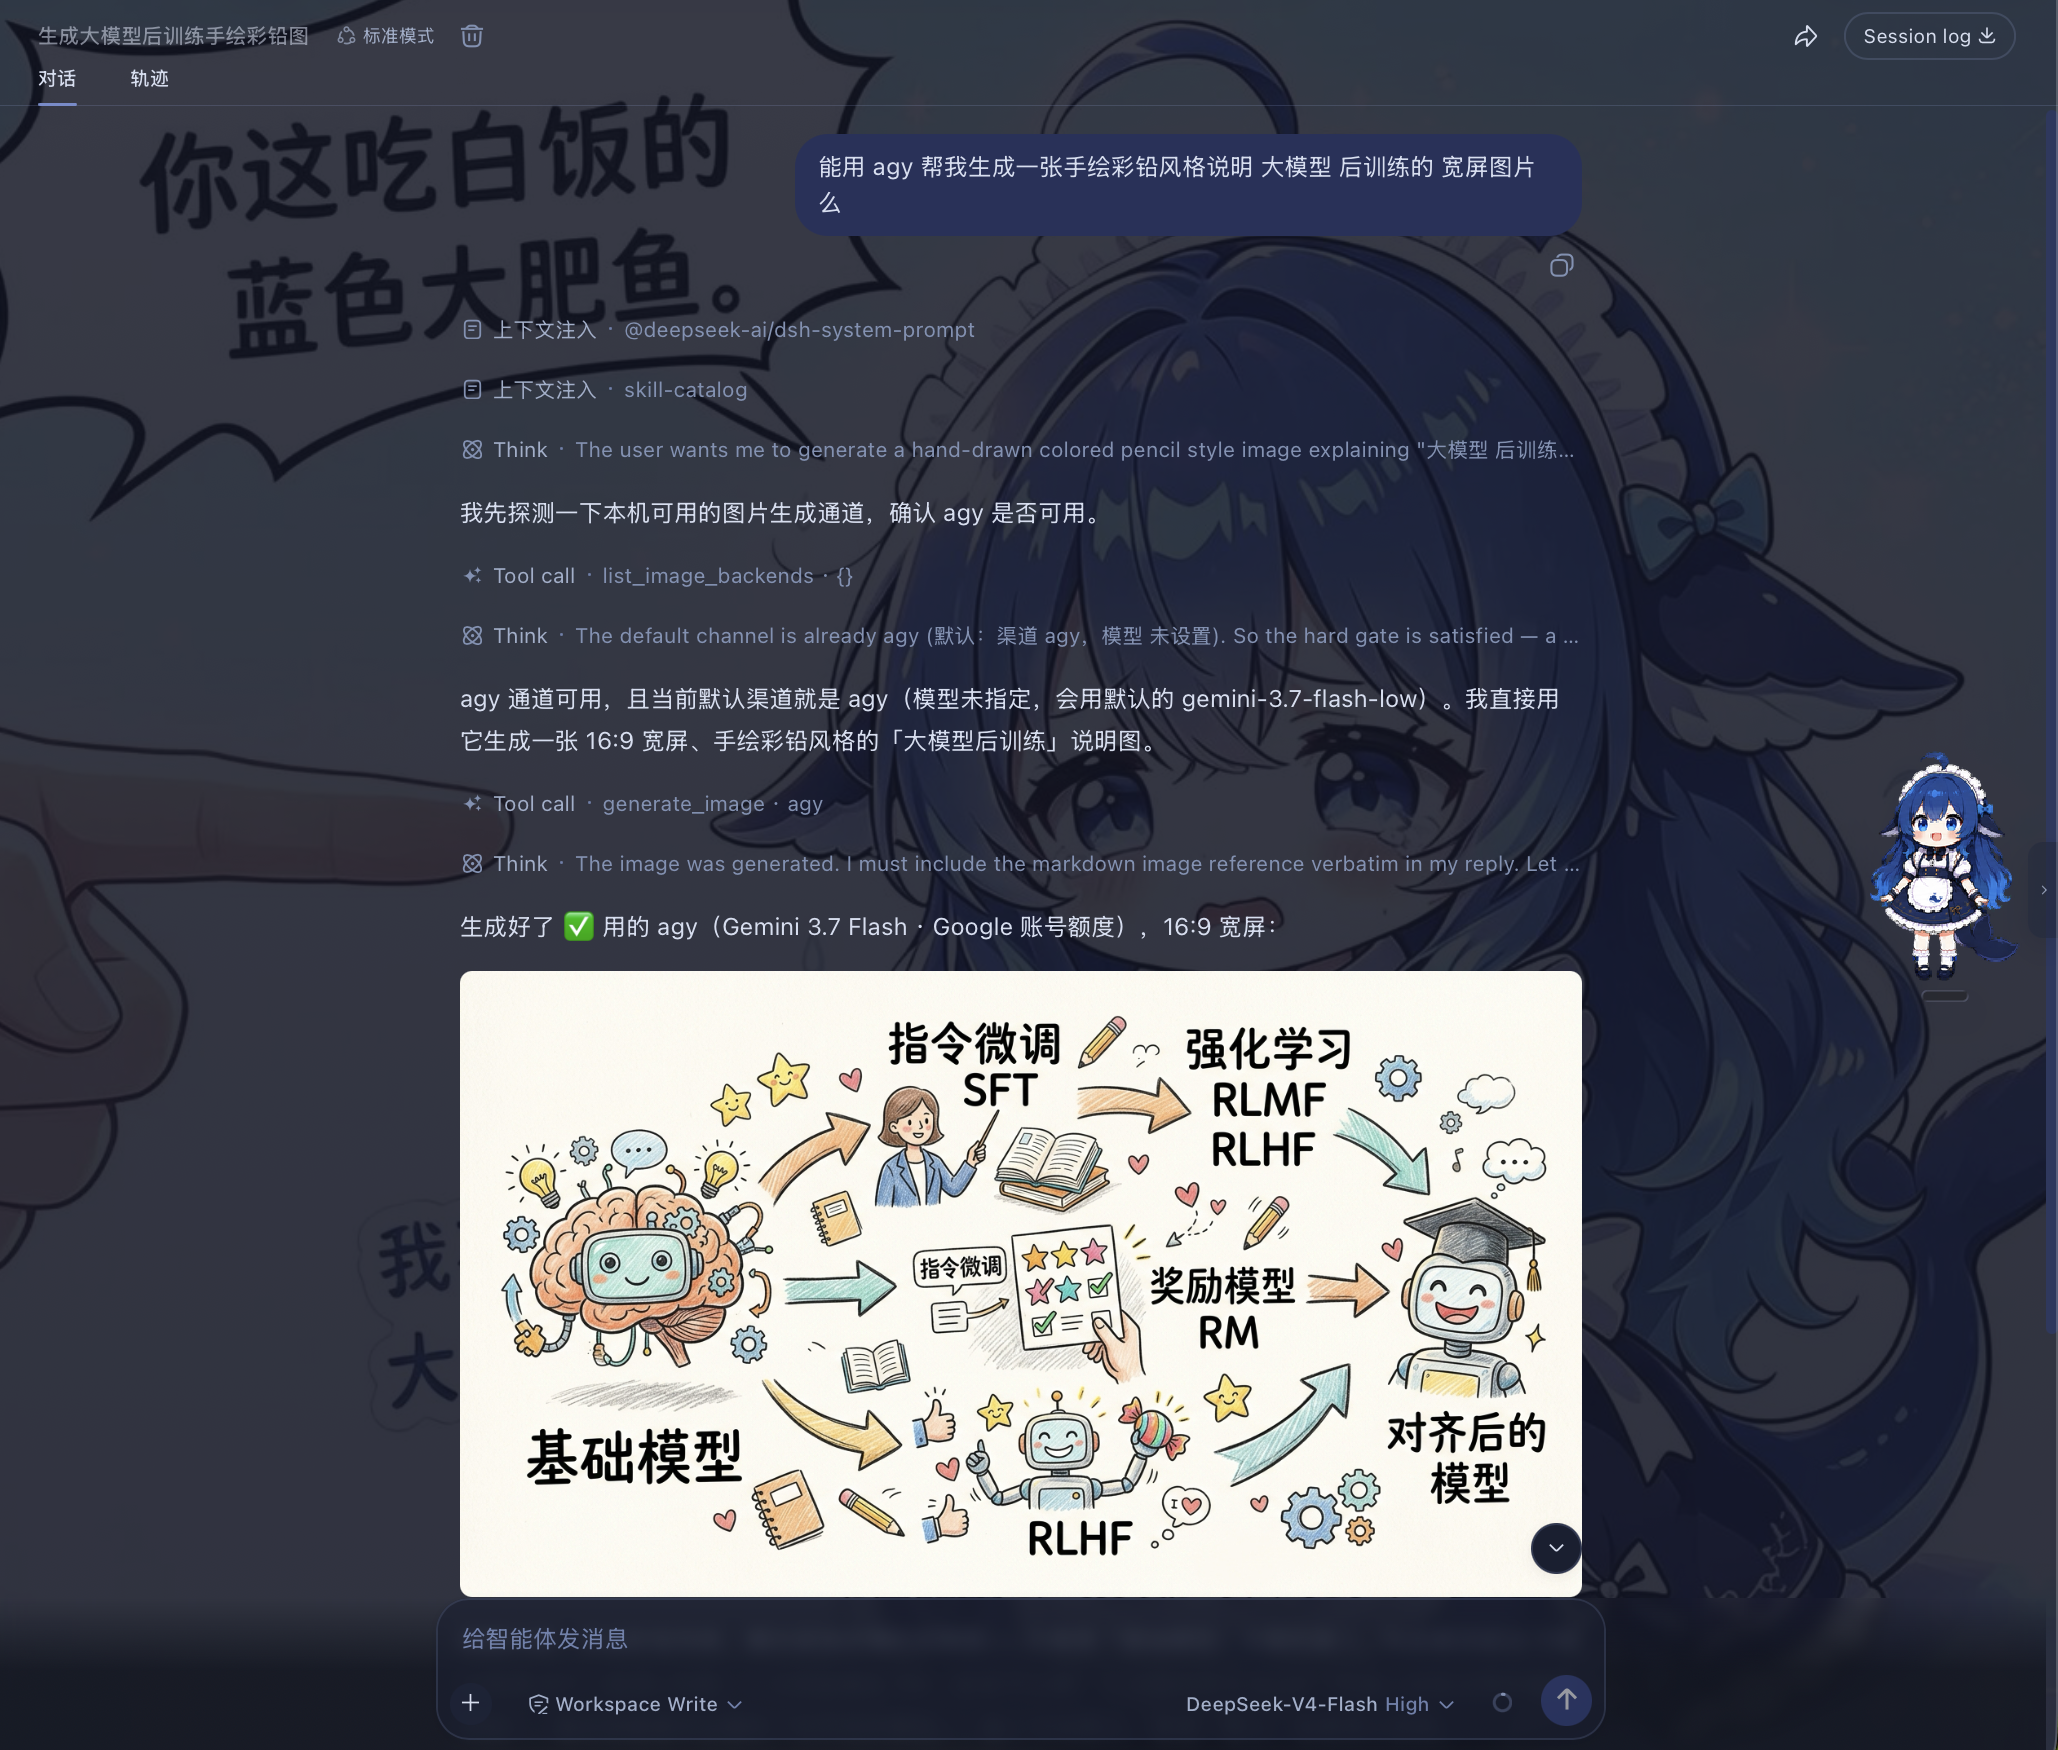
在对话中直接说明即可,例如:
用 agy 生成一张手绘彩铅风格说明大模型后训练的宽屏图片
识图(读图)
识图能力依赖本机 CLI:装了 mmx / codex / agy 任意一个,analyze_image 工具即可用(三者任一即可,无需全装);一个都没装时插件照常工作,只是不提供识图——调用会返回「未发现 CLI」的说明。装好后工具把图片(本地路径或 http(s) URL)读取成结构化 JSON 证据——OCR 全文与逐行文本、按阅读顺序排列的版面区域、语义实体与关系、视觉线索、不确定项清单。
帮我读一下这张图 /tmp/screenshots/error.png,把报错原文抄出来
- 任何模型可用:工具走 CLI 渠道的视觉模型(MiniMax VLM / ChatGPT / Gemini),当前会话不需要切换到视觉模型——这是与 modlens 那类「接管模型路由」方案的主要区别。
- 契约借鉴 modlens:同一份证据结构(五段式),刻意不含坐标框与置信度(视觉模型最容易编造的字段)。
- 渠道选择:
mmx(最快,直连 VLM,约 3-8 秒)→codex(服务端强制 JSON schema,最稳)→agy(Gemini,额度周桶共享)。可用set_image_default的visionBackend参数固定默认识图渠道,不设则自动按速度选。 - 失败降级:某渠道额度耗尽时,对话里说明换一个即可(
backend参数或直接说「用 codex 读」)。
注意事项
- 当前仅在 DSH Web profile 中测试通过。
- 图片只保存在 DSH 进程内存中;重启后历史图片链接会失效。需要保留时请从聊天界面保存。
许可证
链接
同类插件
liustack/modlens★ 4076
为纯文本模型架起视觉桥梁:粘贴图片,输出结构化 JSON 证据(OCR、版面、语义)。
ysr666/dsh-vision-router★ 1129
为纯文本 Agent 提供视觉能力:内置免 Key 视觉链 + 像素级视觉工具(看图问答、定位、裁剪、像素对比、取色、OCR、矢量化、抠图、截图);粘贴图片即可用。
Anionex/dsh-vision-toolkit★ 885
让纯文本模型处理视觉任务:粘贴图片后自动切换到 Vision Toolkit 变体,支持图片问答、多图比较、长截图 OCR、截图还原前端 UI、元素定位与像素对比。默认无需 API Key——图片经作者自建的免费服务处理,每台机器每天 100 张;也可改为指向自己的服务商。
dickpy/dsh-imagegen★ 96
面向 DSH Web GUI 的 AI 生图插件:通过可配置的 OpenAI 兼容端点(gpt-image-2 / gpt-image-1 / dall-e-3)实现文生图与图生图,提供 api_url/api_key 设置卡片与侧边栏分栏生图工作台。
fandc520/dsh-comfyui★ 89
让 DeepSeek Harness 的 Agent 直接驱动本地或远程 ComfyUI:comfyui_run / comfyui_object_info / comfyui_workflow 工具生成与编辑图像、视频,附带工作流库(图工作流提取:按分量 / 主流程 / 整体)、加载区分辨率自动匹配、实时队列、SDXL 与 Wan 2.1 模板、配套 skill 与同源媒体代理。
sunxin-ai/dsh-design-qa★ 44
给纯文本模型的设计稿保真判定:`deepseek_vision` 工具从任意 OpenAI 兼容视觉路由借来一只眼,让模型判断实现与设计稿是否一致——并附上支撑该判定的基准(4 组夹具、23 处注入缺陷、逐格原始输出)与其依赖的提问纪律。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。