DSH 精读与摘要:书籍/论文/视频/网页经可插拔解析器转成结构化 Obsidian 笔记,MapReduce 并行精读子代理、JSON Schema 输出与幂等缓存。
安装
# npm 包(预构建)
dsh plugin --profile web add deep-read-summarize
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:PensiveFei/deep-read-summarize
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
English | 简体中文
把论文、书籍、视频或网页整理成一份可以继续阅读、编辑和回查的 Markdown 笔记。
这是一个运行在 DeepSeek Harness(DSH) 中的第三方精读插件。它尝试获取来源全文,将长内容分块阅读,再合并成带 YAML frontmatter 的结构化笔记。你可以把结果放进 Obsidian、Logseq 或其他 Markdown 工具。
先看真实笔记 · 安装与第一次使用 · 了解质量与限制 · 常用配置
AI 笔记可能遗漏或误解原文。请把它作为辅助阅读的起点,关键事实与引用仍需对照来源。
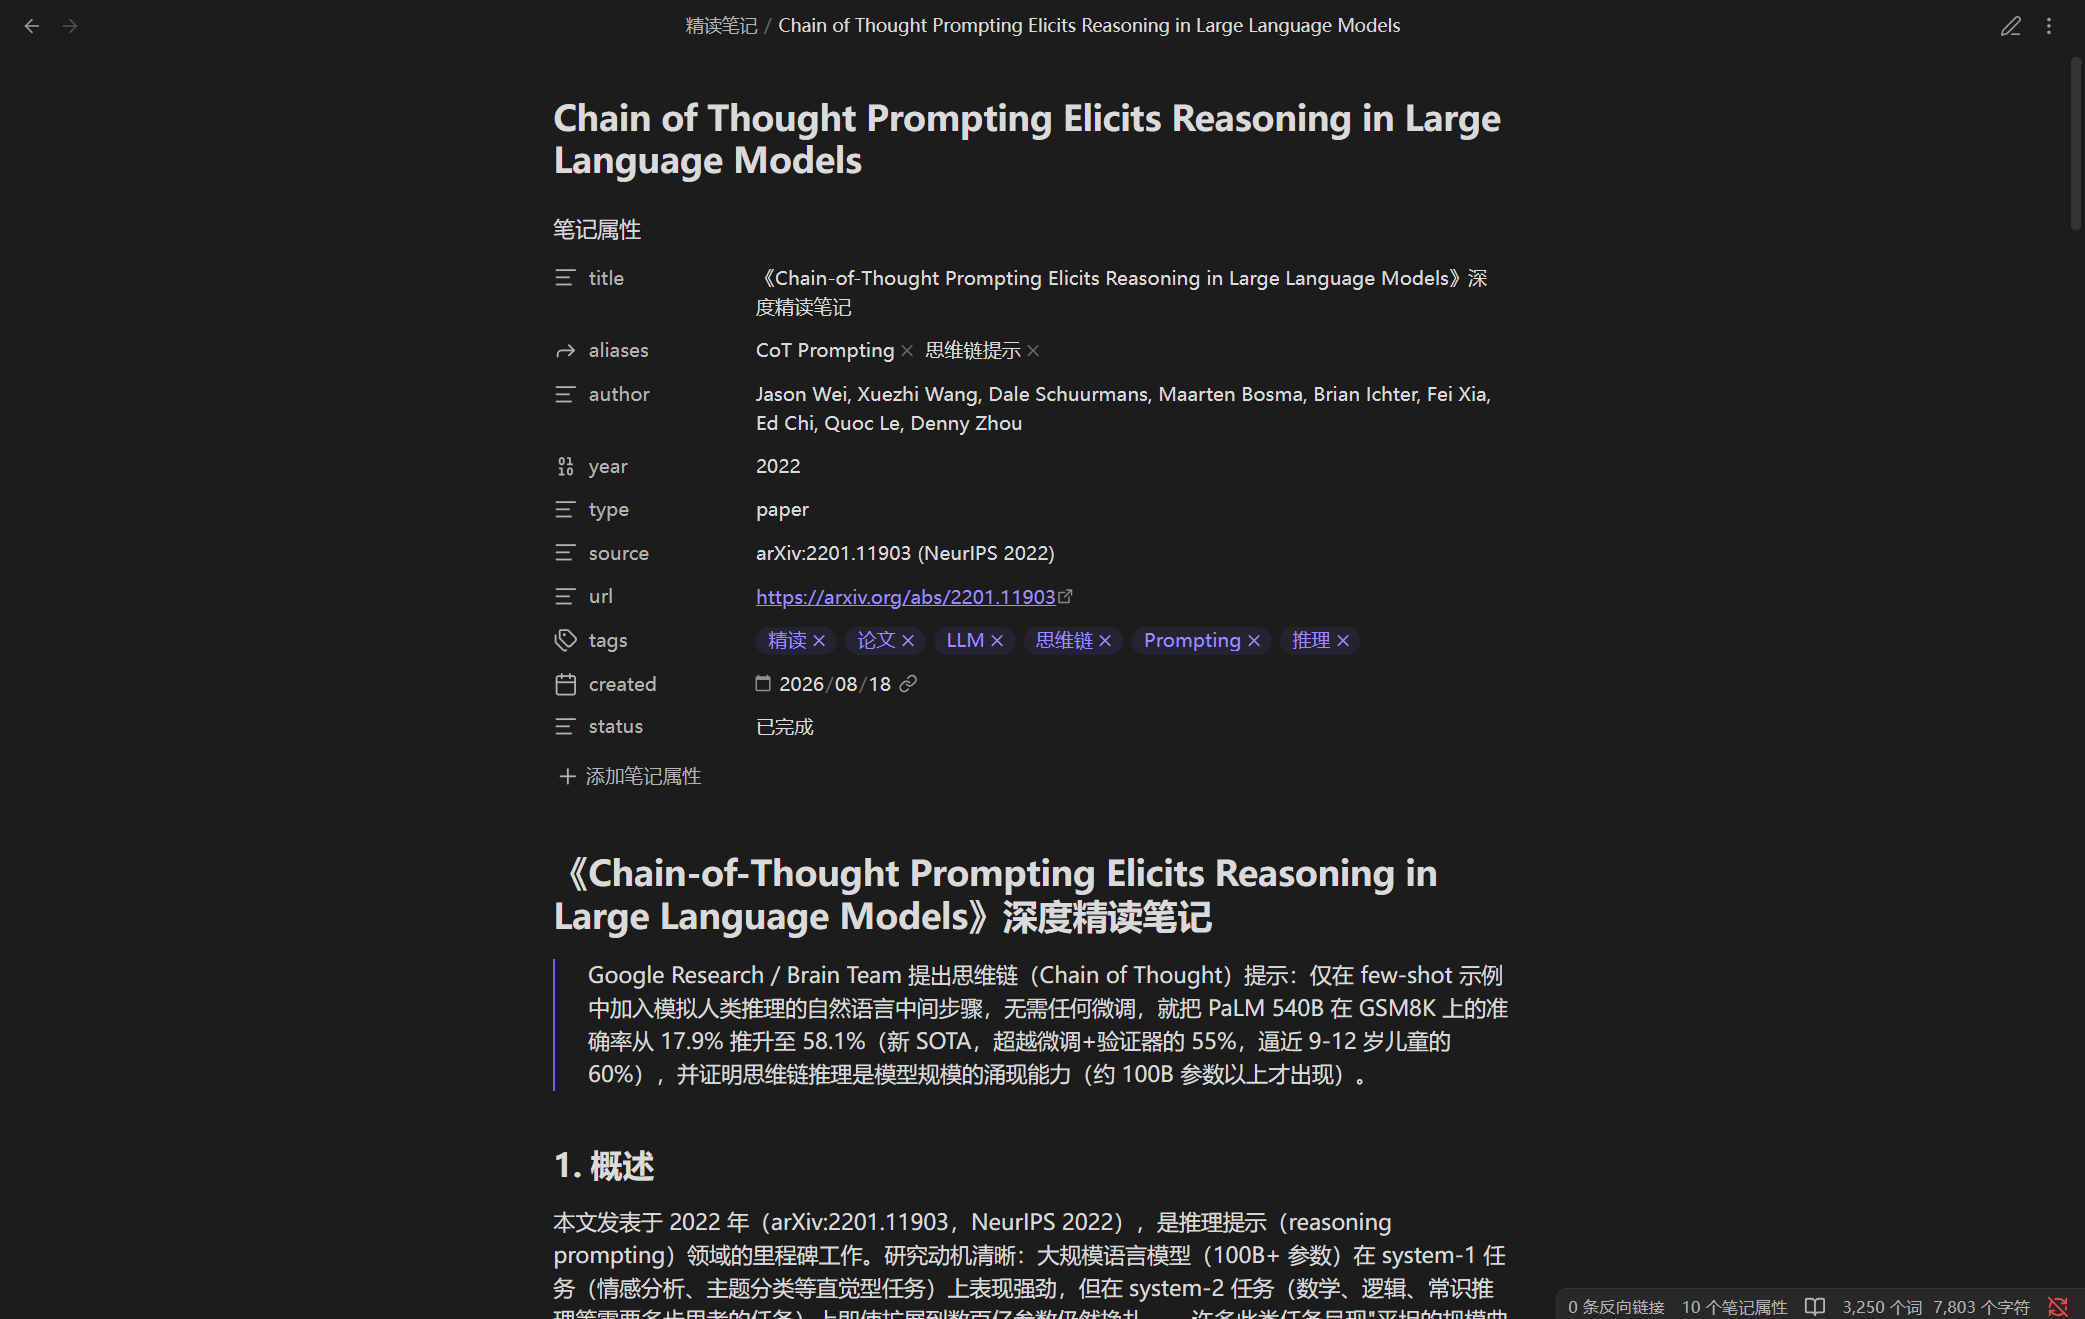
看看笔记
这些是维护者提供的历史笔记:两篇论文有早期项目运行记录,视频笔记的生成方式尚未确认。模型、项目版本和运行耗时未记录,它们不是当前版本的性能承诺。部分引文和时间戳已抽查、并标注了公开副本的修改;详见示例说明。
它能做什么
| 你提供 | 工作流尝试获取 | 你得到 |
|---|---|---|
| 书籍:PDF、EPUB、MOBI | 文本和章节 | 按主题整理的阅读笔记 |
| 论文:arXiv、PDF、HTML | 论文正文和结构 | 研究问题、方法、结论与局限 |
| 视频链接 | 优先字幕;无字幕时可尝试本地转写 | 基于已取得文本的内容拆解 |
| 网页链接 | 页面正文 | 要点、概念和来源信息 |
实际提取结果取决于来源是否可访问、工具是否可用、模型和宿主权限。扫描版 PDF 通常需要先进行 OCR,工作流不内置自动 OCR;复杂公式、图表以及质量差的字幕或音频可能需要人工处理。
笔记通常包含概述、结构拆解、术语表、关键引用、批判性分析和应用思考。最终内容仍由模型生成,不同输入和配置可能产生不同结果。
开始使用
1. 安装插件
先安装并启动一次 DSH Desktop,让它初始化桌面 profile;然后完全退出应用,使用 Desktop 随附的 DSH 命令安装:
dsh plugin --profile desktop add deep-read-summarize
安装完成后重新打开 DSH Desktop。随附命令不一定在系统 PATH 中:可使用安装目录下 resources/runtime/cli/bin/dsh(Windows 为 dsh.cmd)。界面和命令可能随宿主版本变化,详见 DSH Desktop 官方说明。请勿在 DSH profile 目录中直接运行 npm install 或 npm update。
运行精读还需要 DSH 中可用的模型和相应权限;不同来源可能需要额外工具。例如 PDF 文本提取可能需要 pdftotext,YouTube 字幕获取可能需要 yt-dlp,无字幕视频的本地转写可能需要 uv 和转写模型。
2. 发起一次精读
在 DSH 对话中输入,例如:
请帮我精读这篇论文,并生成一份 Markdown 阅读笔记:
https://arxiv.org/abs/2307.09042
你也可以提供本地文件路径、网页或视频链接。如果需要,可以在请求中说明输出位置、希望保留的章节或是否需要时间戳。
想要短一些,可以说“请生成简洁笔记,保留要点、术语和关键引用”。主代理可选择简洁模式,默认最低计数为 500 并省略第 5–7 节,仍保留原文核验;如需批判分析等章节,可以在请求中说明。最低篇幅并非字数上限,实际长度仍由模型决定。
支持插件工具的宿主会注册 deep_read_summarize;旧宿主使用插件提供的技能和 workflow 入口。精读工具返回笔记正文及建议路径,实际写入文件需要由主代理完成。生成后请确认文件已保存,并检查结果中是否报告内容缺口或质量问题。
当工作流提取被包装的笔记时,可选字段 draftContext 会记录提取方式,以及模型在笔记前后附带的额外说明。这些额外文字不是经过原文核验的笔记正文。
{
  "input": "https://arxiv.org/abs/2307.09042",
  "type": "paper",
  "options": {
    "maxChunks": 4,
    "outputDir": "./output"
  }
}
type 可选 auto、book、paper、video 或 web。显式指定类型可以跳过部分模糊输入的识别步骤。具体工具调用方式取决于 DSH 宿主;也可以直接在对话里表达需求。
结果能信到什么程度?
工作流会规范化分块范围,程序检查格式和篇幅,独立核验代理读取取得的文本并给出分块与引文证据。插件工具入口还会在宿主侧读取本次原文,对照文件实际行数和第 4 节提取出的逐字引文;读取失败、原文变化或引文不匹配时不会标为通过。结果可通过 qualityPassed、qualityChecks、qualityEvidence 和 citationVerification 查看。
sourceStatus 表示来源状态:complete 仅表示获取的文本与用户提供的本地纯文本逐字节一致;partial 表示已知只取得部分内容;unknown 表示无法确认完整性,包括网页、PDF 提取结果和视频字幕/转写。sourceComplete 保留为兼容布尔值,仅 complete 时为 true;false 同时涵盖 partial 与 unknown。来源状态会写进笔记,unknown 下即使其他检查通过,也不能断言取得了原始来源全文。
citationVerification.status 为 verified、mismatch、unverified 或 not_applicable。旧式裸 workflow 入口没有宿主文件读取能力:需要核验引文时,它会报告 unverified 和质量未通过。程序匹配只检查第 4 节识别出的逐字引文和对应行范围,不能证明其余结论或改写正确。
质量未通过时,保存的笔记开头会保留提示、失败分块及最多 5 项问题;默认 Obsidian 和 generic 模板中的完成状态会在可安全识别时改为“待核验”。完整问题列表仍在 qualityIssues 中。
这些检查有边界:
- **
qualityPassed不是事实正确性的证明。**语义覆盖与论证判断仍依赖代理;来源为unknown时检查通过也不证明获取完整。重要结论、数字和引用请自行复核。 - **取得全文不等于理解了全文。**复杂表格、公式、图片以及提取错误可能影响结果;来源不完整或分块失败时,结果会报告缺口。
- **字幕或转写不等于音频原文。**自动字幕和语音识别可能漏句、听错数字或否定词;核验笔记与逐字稿不能证明逐字稿本身准确。
- **视频时间戳不能凭空推算。**可定位性取决于取得的字幕或转写是否包含时间信息。
常用配置
| 选项 | 默认值 | 用途 |
|---|---|---|
lengthMode |
standard |
设为 concise 使用简洁预设,默认 minWords: 500、fastMode: true |
minWords |
2500 |
最低篇幅要求;检查规则按中文字符和其他文字的词计算 |
fastMode |
false |
开启后省略批判性分析、个人应用和延伸阅读章节 |
maxChunks |
4 |
分块数量上限,最大为 12;不是并发数 |
readConcurrency |
3 |
精读并发上限;并发更高不一定更快 |
maxRetries |
0 |
未通过质量检查时的修订次数;成稿成功后默认执行一次核验,不做修订 |
outputDir |
./output |
建议的笔记输出目录,由主代理完成写入 |
requireCitations |
true |
要求关键引用具备可核验的来源信息 |
includeTimestamps |
false |
视频笔记是否要求时间戳 |
transcribe |
true |
视频没有可用字幕时,尝试本地转写 |
whisperModel / language |
small / zh |
选择转写模型和语言;英文视频可显式指定 en |
device / cpuThreads |
cpu / 0 |
选择转写设备和 CPU 线程策略 |
transcriptCache |
true |
相同音频及匹配配置时复用已验证的转写缓存 |
parallelQuality |
false |
显式启用并行原文核验;默认保留原核验路径 |
readCache |
false |
可选的跨次精读缓存;仅插件工具入口支持 |
直接调用时可用 options: { "lengthMode": "concise" }。同一次调用显式提供的 minWords、fastMode 优先于预设;例如加上 "fastMode": false 可保留完整章节。简洁模式尽量接近最低篇幅,但不限制最大字数。
开启 readCache 时,还必须提供 readCacheIdentity,写明供应商、固定模型版本及影响输出的设置;这些信息变化时需更换身份。该身份由调用者提供,宿主无法自动验证。缓存为本地明文,可能包含原文摘录;命中后仍会执行独立原文核验。
其他选项包括 frontmatter(obsidian、generic、minimal)和 tempDir。高级选项、取值范围、转写缓存和自定义解析器可参考完整配置与技术参考。
时间、费用与隐私
- 时间取决于内容长度、获取方式、分块数量、模型和宿主并发。没有字幕的视频需要额外转写,首次使用还可能下载转写模型。
- 费用取决于你配置的模型、输入与输出量;本项目不能保证固定的耗时或费用。
- 隐私:本地语音转写在本机运行,但后续精读使用你在 DSH 中配置的模型。若使用云端模型,原文、字幕、笔记或相关上下文可能发送给对应服务商;请先确认其数据处理条款。
- 本地文件:临时原文、转写和可选缓存可能保存在设备上;处理敏感资料前请确认目录权限与清理方式。
出问题时
- 插件不可用:确认已在正确的 DSH profile 安装、重启了桌面应用,并检查宿主版本和插件兼容信息。
- 获取失败或笔记缺段:确认链接可访问、所需工具已安装;查看返回的阶段、来源状态和失败分块。
- 只有视频简介:说明没有取得可确认的完整字幕或逐字稿;请检查字幕与转写条件,或提供文本。
- 质量检查未通过:查看
qualityIssues和qualityEvidence,必要时对照原文修订;不要把未核实的笔记当作完整结论。
仍有问题?欢迎在 GitHub Issues 提供操作系统、DSH 与插件版本、输入类型和错误信息。请先去掉密钥、私有链接和个人资料。
开发与贡献
源码开发请在独立的项目目录进行,而不是在 DSH profile 目录运行 npm:
git clone https://github.com/PensiveFei/deep-read-summarize.git
cd deep-read-summarize
npm ci
npm test
npm run test:node
npm run lint
npm run validate
项目使用解析器处理不同输入类型,支持自定义解析器。代码和测试见仓库,版本变化见 CHANGELOG,贡献方式见 CONTRIBUTING。
精读质量基准提供 16 个公开可用的短样本、逐条参考事实和离线计分工具;语义质量需要人工复核,不能把未评审的结果视为得分。
**兼容性:**本项目此前验证过 DSH 0.2.0-rc.2 的相关宿主契约;DSH 接口可能变化,其他版本请以实际测试和兼容说明为准。
版权与声明
项目代码采用 MIT License。示例中引用的论文、视频和短引文仍受其各自权利与授权条件约束。
deep-read-summarize 是独立的第三方项目,与 DeepSeek 或 DeepSeek Harness 官方没有隶属、认可或赞助关系。
链接
同类插件
loopx-project/loopx#dsh-loopx-plugin★ 6722
LoopX——面向长周期 Agent 的提供商中立、本地优先状态内核与控制平面:在 DeepSeek Harness 执行层之上持久化 Goal、Todo、门禁、证据、配额、恢复与交接状态;插件负责引导安装 CLI 与技能、准入有界的同会话续跑,并为精确绑定的工作循环提供本地 GoalBar。
Q00/ouroboros#integrations/dsh-plugin★ 6381
通过 DSH MCP 客户端挂载 Ouroboros 的纯配置包,在 DSH 中提供 36 个涵盖需求访谈、Seed、执行、评估与演化流程的工具。
chuspeeism/dashi-taskboard#deepseek-harness★ 3507
把当前已安装并运行中的 Codex Taskboard 嵌入 DeepSeek Harness 侧边栏,并通过 Launcher 运行时描述文件连接,而不是使用固定端口。
NanmiCoder/dsh-agent-teams★ 3026
AgentTeams 多智能体团队。
EthanYoQ/AI-Novel-Writer#dsh-ai-novel-writer★ 2711
安装专用 AI 小说创作预设与工作台:提供带修订号的本地项目资产、紧凑侧边工作台,以及需要原生审批的逐文件变更。
shanliuling/dsh-image-gen★ 1626
为 DeepSeek Harness 提供原生对话生图能力:直接让 Agent 画图,插件自动完成生成并把结果保留在当前会话中。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。