为 DeepSeek Harness提供持久化的项目级记忆。专门针对项目开发,原生融合 dsh 任务系统,会话内任务清单与读过的文件自动沉淀为跨会话任务记录,任务↔文件自动关联——开发工作流可切换、可续接,无需重复梳理整个项目。文档与代码符号在读取时索引,无需全量预扫;针对不同语言的项目,支持可选功能增强。经验笔记自动去重,避免重复记录。所有数据召回附带出处可溯源。纯 JS、单依赖、静默运行、零操作成本。
安装
# npm 包(预构建)
dsh plugin --profile web add @yolk_vat-y/dsh-project-memory
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:00080000/dsh-project-memory
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
如果这个插件帮你省下 1 小时 Debug 时间,请点个 Star。

为 DeepSeek Harness(dsh)agent 提供持久化的 项目开发记忆。专门针对项目开发,原生融合 dsh 任务系统,会话内任务清单与读过的文件自动沉淀为跨会话任务记录,任务↔文件自动关联——开发工作流可切换、可续接,无需重复梳理整个项目,解决上下文失效;文档(PDF/Markdown/txt)与代码符号写入工作区独立存储,文档自动交叉链接至所提及的代码符号;经验笔记(问题 → 方案)自动去重,避免重复踩坑。所有数据按项目落盘,跨会话压缩与交接保留,召回附带 路径:行号 可回源核实。单依赖,无向量数据库,无原生构建。
插件在磁盘上维护一份精简的项目记忆,每条记录指向具体的文件与行号;agent 需要快速了解项目时先查记忆,无需重读整个项目。
特性
- TaskBridge:跨会话开发任务 — 会话内的任务清单与触碰过的文件持久化为跨会话的项目任务实体,工作流可以随时切走再续接,不必重新界定项目范围。关联文件按最近活跃排序(读取永远不越过写过的文件),续接时一眼看到该先看哪些。新会话通过
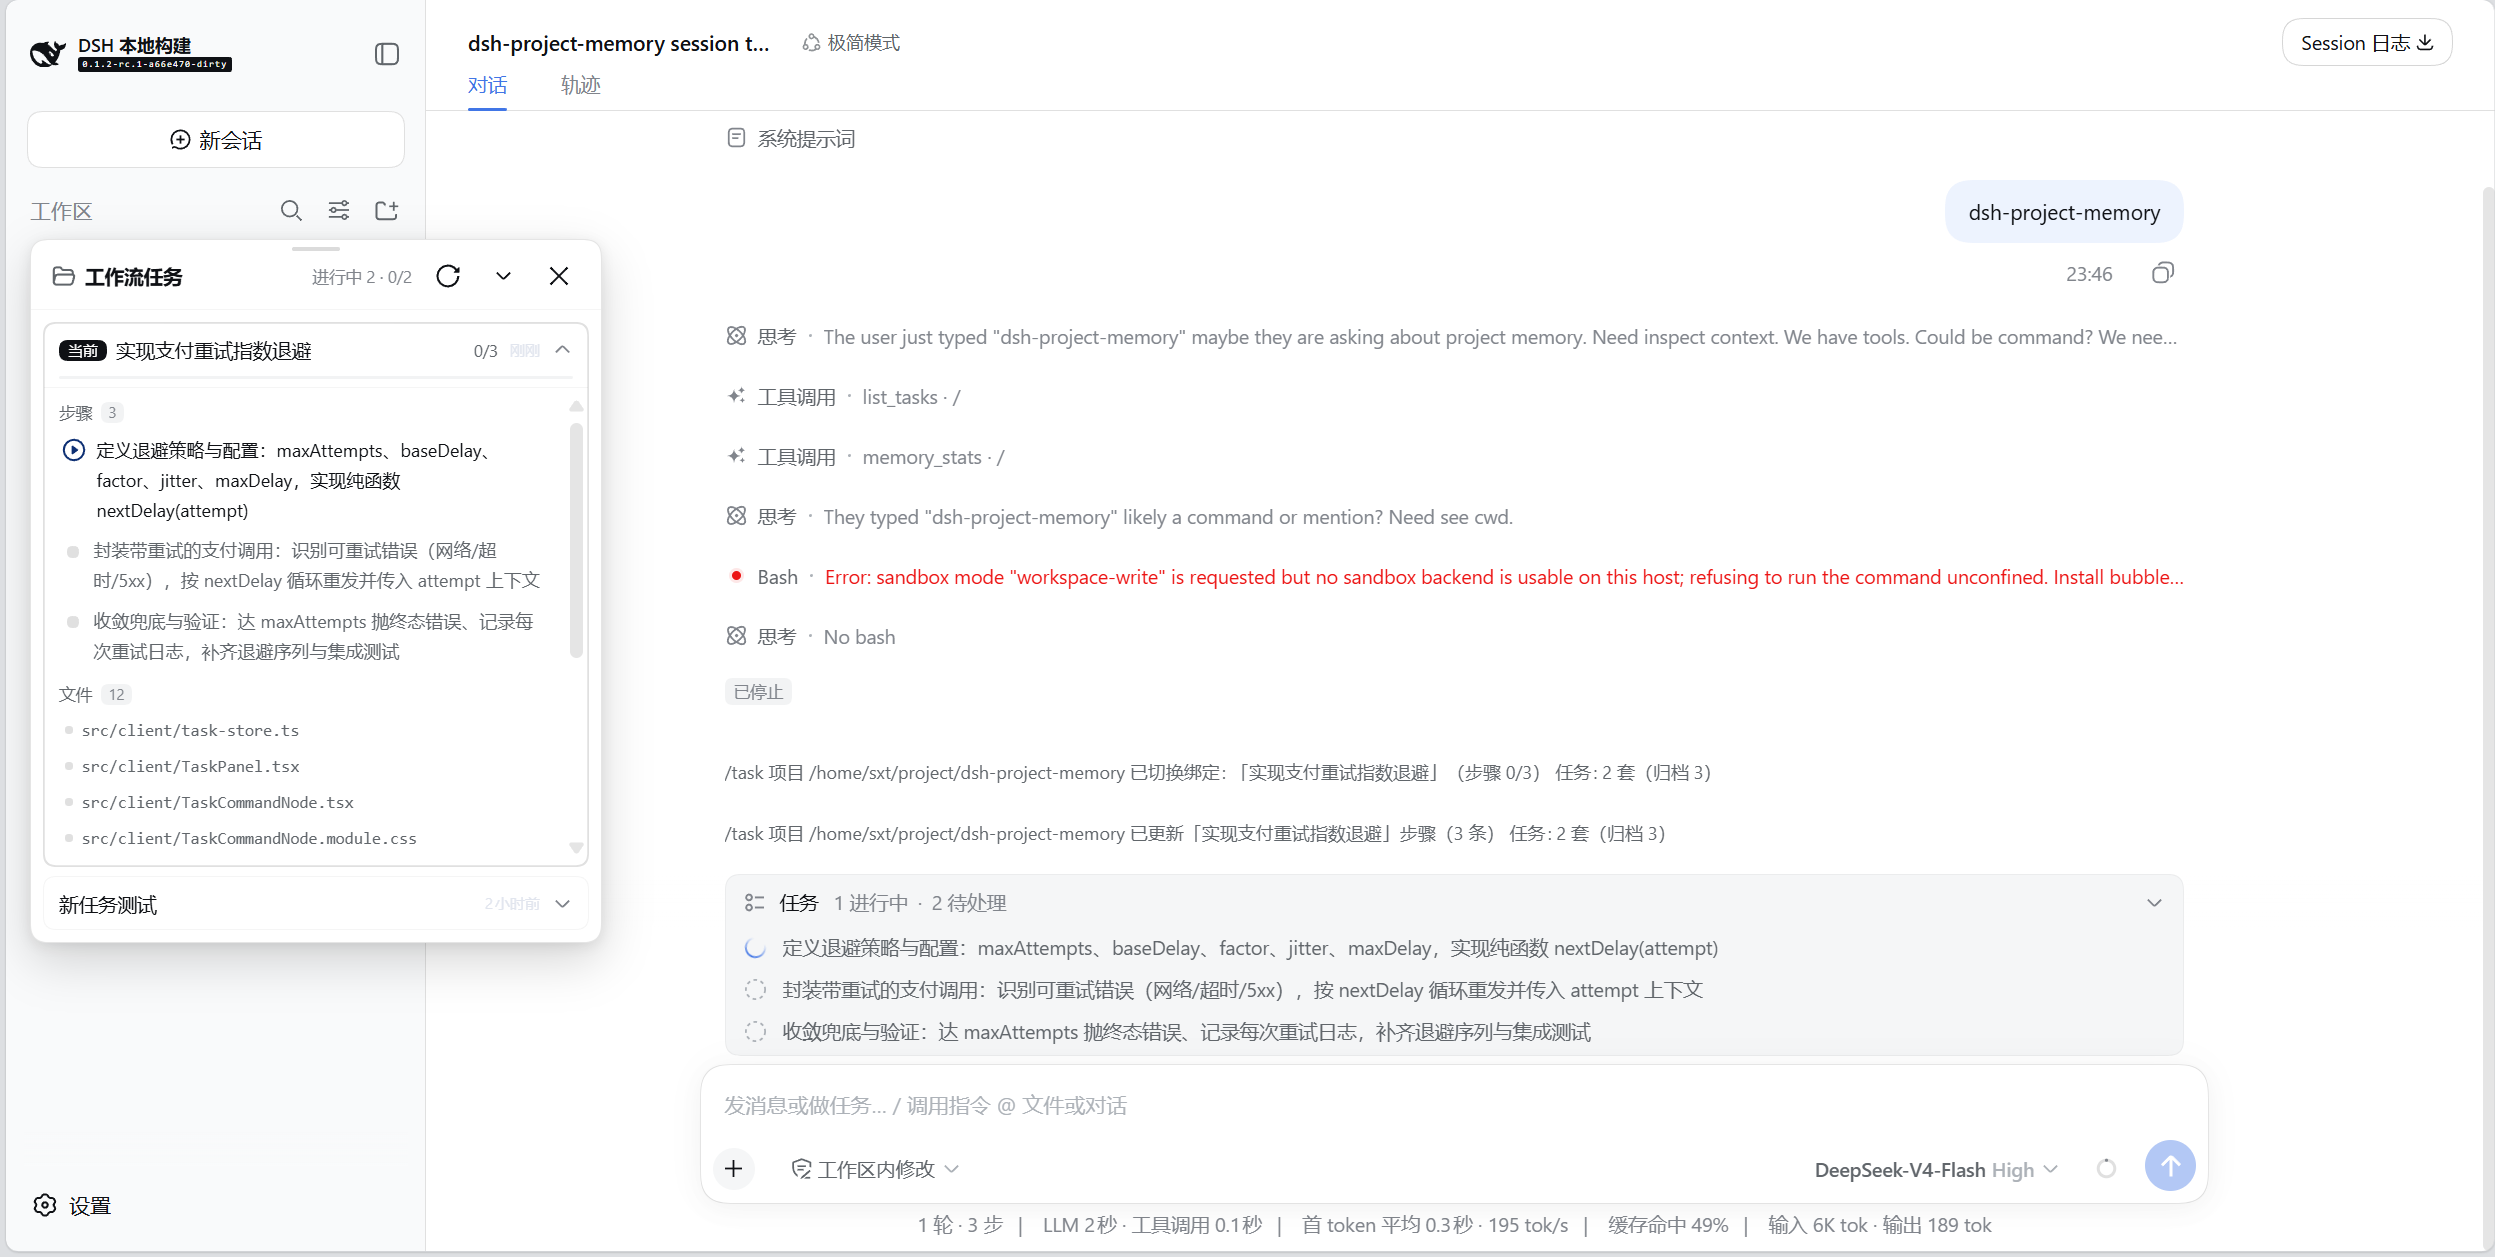
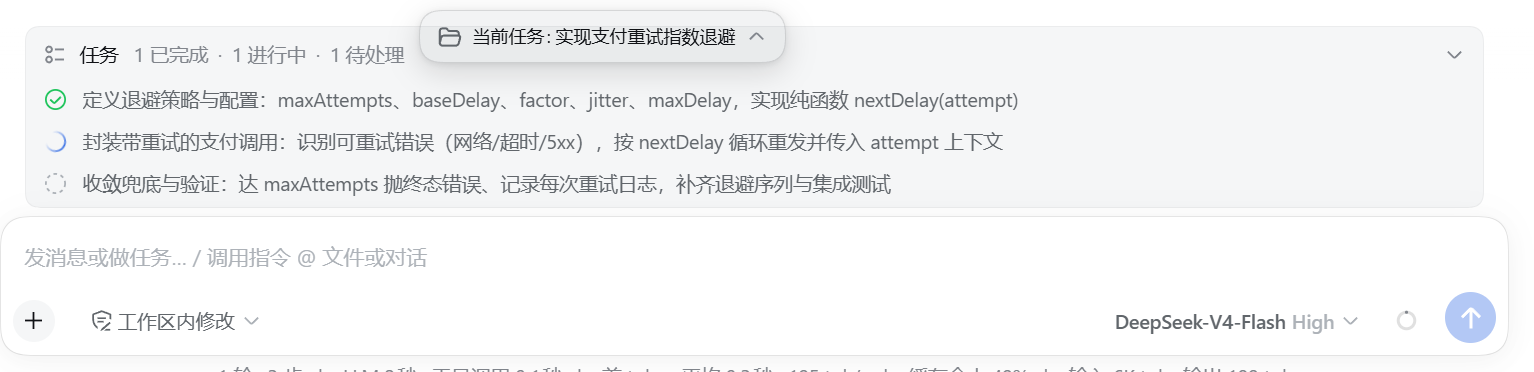
list_tasks→select_task续接。委派给子代理的工作不会建档(见「已知限制与边界」)。自动同步需要含会话事件的 dsh 构建;旧宿主下降级为纯记录。 - dsh web 浮动任务面板(v0.4.2+) — 卡片可拖拽,展示任务步骤与涉及文件,可折叠为迷你条或彻底隐藏。面板默认隐藏,仅在显式唤起后出现;会话切换只后台同步,刷新页面不会自行打开。渲染错误有边界兜底,面板崩溃不会拖垮宿主。
- 面板编辑与外观(v0.4.2+) — 绑定卡片支持标题与步骤的行内编辑、步骤状态循环切换;非绑定卡片只读。四档外观风格只改材质、几何、字型与密度,颜色跟随宿主。
- 任务清单双向同步(v0.4.2+) — 绑定任务时把步骤推给宿主任务清单,面板编辑与模型更新写回同一套逻辑。配置
tasklist.syncHostOnAdopt可关闭。 - 文档记忆 — PDF、Markdown 与纯文本按块切分并生成摘要,索引期不调用模型。每条保留一段简短摘要供注入、一个覆盖整个 block 的有界检索词集合(召回不受开头几行限制),以及回源引用。
- 代码符号记忆 — 零依赖扫描器提取函数、类、方法、接口与类型别名及其完整签名,覆盖 8 种语言,一行一条。项目装了
typescript时,可选第二层补推导返回类型、泛型与接口,异步执行、按内容哈希缓存、不阻塞索引。 - 自动刷新 — 后台轮询按内容哈希识别新增与变更文件,只重记这些。
- 读到即记忆 — 文件在模型实际读取的瞬间被记忆,记忆是正常工作的副产品,而不是额外的一次全量扫描。从未读过的文件不会被记忆。
- 文档 ↔ 代码交叉链接 — 文档提及的符号,在查询该符号时一并带出。
- BM25 记忆召回 — 对文档、符号、经验笔记与 insight 排序召回,可选 LLM 查询扩展。针对 CJK 增强:短语加分、同义词表,以及文档↔符号链接的词边界处理。
- 经验笔记 — 记录问题 → 方案;相似问题覆盖而不重复,数量随项目规模有界,仅在检索命中时返回。
- 分层 insight 记忆(教训 / 决策 / 流程,v0.5) — 同一实体贯穿任务、项目、全局三级。近重复合并或强化;提升是更换归属而非复制。被使用会记账,因此衰减与容量按活跃度排序,而不是只按时间。LLM 反思默认关闭,只写任务级草稿。面板提供分级的记忆视图用于审核与编辑。
- 触发式注入 — insight 可携带 authored trigger:只有
when能触发,guard只能收窄,prevents记下没有它会坏在哪。语料正文永远不能触发注入;统计通道另有独立门槛。 - 流式 TF + IDF 缓存 — 查询路径按存储版本缓存词权重(实测数字见「性能」)。只有真实写入才清空缓存,watch 轮询不会把查询刚建好的缓存清掉。
- 无锁同步事务 — 所有写入走同步事务,
remember/forget不会排在重索引之后。锁在进程内:不要让两个 dsh 实例写同一个 store。 - 依赖极简 — 纯 JavaScript;运行时只有一个用于 PDF 文本提取的依赖,无需原生构建。
- 开销可忽略 — 记忆操作在进程内完成;瓶颈是文档提取与磁盘 I/O,而不是打分。
安装
插件只依赖通过 peerDependencies 声明的稳定公共 API(defineTool、llm.stream、Schema)。
cd dsh-project-memory && dsh plugin --profile web add . -w
-w(workspace-root)标志是必需的:profile 目录是 pnpm 工作区根目录,不带该标志 pnpm 会拒绝 add。其他目录下同样可用路径形式:dsh plugin --profile web add /path/to/dsh-project-memory -w。
插件同时发布在 npm 上(scoped 包):
dsh plugin --profile web add @yolk_vat-y/dsh-project-memory -w
每个被索引的项目在 <root>/.dsh-project-memory/ 下有独立存储。如无需入库,可加入 .gitignore。
用法
以下工具由 agent 自动调用,无需用户手动输入。在对话中直接说自然语言即可——例如「给这个项目建个索引」或「auth 模块是干嘛的」,或者正常开发即可——agent 会自动调用对应工具。默认开启「读到即索引」(lazyIndexing):模型读哪个文件,就顺便索引哪个文件,记忆在你干活的过程中自然积累。watch_repo 让显式监听的根目录在后台保持新鲜;index_repo 强制对项目做一次全量回填(未变更文件自动跳过)。
| 工具 | 用途 |
|---|---|
index_doc file_path |
索引单个文档(PDF/MD/txt):分块 → 确定性 summary + 整 chunk terms → 带 路径:行号 入库。未变更文件自动跳过。 |
index_repo root |
索引整个项目:文档生成确定性摘要 + 整 chunk 词项,代码文件生成零 token 符号表。增量更新、清理已删除文件、文档与符号交叉链接。根目录不存在(含在 Linux/macOS 上被解析成相对路径的 Windows 风格路径)或在排除名单上时,会在写入任何内容前拒绝。 |
watch_repo root |
启用自动刷新:后台轮询检测新增/变更文件(mtime + 内容哈希),仅重抽这些文件。监听的项目在插件重启后自动恢复;不存在或在排除名单上的根目录会被拒绝,已消失的根目录会被丢弃而不是被重新创建,不再有效的条目会在启动时清掉。 |
memory_stats root |
查看记忆库内容:总量(文件 / 条目 / 经验笔记)、最近索引时间,以及按时间排序的逐文件清单。 |
query_memory query |
对文档、符号、经验与 insight(教训/决策/流程)执行 BM25 检索,可选 LLM 查询扩展。type 选择层(all / doc / symbol / experience / insight / task)。返回带相对分数(0-100)、引用或 insight id、以及文档→符号链接的排序结果。 |
list_tasks |
列出本项目任务记录(含归档,带标记)。新会话/续接前先调用。 |
select_task |
将会话绑定到某任务(此后 todo 清单与读文件同步进该任务)。按 taskId 精确绑定,或按 title 完全匹配(多个同名返回候选;无则新建)。带 title 可改名;自动解归档。 |
archive_task |
归档任务(隐藏默认视图、不占容量、停止同步)。select_task 可恢复。 |
show_task_panel |
在 UI 中打开任务面板。用户要求查看任务列表或你想展示面板时调用。 |
/tasks(用户输入,不经模型) |
唯一的用户命令:展示任务栈(标题、步骤进度、涉及文件、当前会话绑定)并驱动工作流卡片。其余动作是它的子动词,由卡片按钮调用、无需手敲 —— /tasks switch / archive / unbind / rename / todos …(任务动作)、/tasks insight list / confirm / promote / demote / archive / restore / delete / save / edit …(记忆动作)。 |
remember problem solution |
保存经验笔记。相似问题覆盖而非重复。 |
forget id_or_query |
删除过期经验笔记。 |
save_lesson(模型工具) |
在 task/project/global 任一作用域保存教训/决策/流程(单一 insight 实体)。近重复按双向 overlap ≥ 0.7 合并、0.65–0.7 强化;同一 insight 被 2+ 任务命中自动 task→project、3+ → global。参数:title、kind、scope、pattern/fix 或 choice/reason 或 steps、trigger(when = ops/writes/intents,唯一触发面;guard = paths/not_paths/hosts/tags,只能收窄;prevents = 准入条件;旧 keywords/symbols/actions/paths/scope 仍接受并自动迁移)、task_id、files、symbols、confidence、root。 |
/tasks 在 web 的 / 菜单里以带图标的**「工作流」组呈现 —— 三个视图入口:任务 / 项目记忆 / 全局记忆
(标题随界面语言切换)。宿主命令只要注册就会出现在一贯的「指令」小节里,且插件无法隐藏它
(commands.list() 与 commands.execute() 读同一个视图,CommandDefinition 没有 hidden 字段),
所以插件的宿主命令只保留 /tasks 一条**,其余动作全部作为它的子动词由卡片按钮驱动:菜单里的重复因此只有一行。
手敲 /tasks 回车即执行(与合并前一致);手敲 /tasks switch x 这类带参数的行不再被识别为命令,请用卡片按钮。
工作原理
设计遵循四个原则:
- 易失性 — 上下文是临时的,会话压缩即丢失。
- 持久性 — 记忆存于磁盘,跨压缩与会话保留。
- 紧凑性 — 代码层每个符号只存一行声明(≤200 字符),文档层每个 chunk 保留 ≤300 字符的
summary与有界的terms。派生数据一律不落盘:doc→symbol 链接与 BM25 的searchText都在读取期计算。最终体积取决于符号密度与 chunk 长度,下面是特定语料的实测值(2026-09-25),不是承诺:纯代码的 Vue 应用(289 文件)实测 325 bytes/条目 ≈ 源码 21%;符号密集的 TypeScript monorepo(12,408 文件 / 代码 106 MB + 文档 14 MB)实测代码层 占源码 22%(整库 553 bytes/条目)、文档层 占其源码 130%。文档占比高的语料单条目最大:一个 274 篇文档的工作区(PDF + Markdown)实测 1,506 bytes/条目。 - 可核验性 — 召回在适用时携带
路径:行号引用,agent 可对照源文件核实。
构建记忆无需预先全量扫描:文件在模型读取时被记忆,记忆恰好覆盖实际处理过的内容。未变更的文件重读是空操作(内容哈希),因此记忆的持续维护开销很低。
存储按项目独立存放,并跟随代码库变化:文件变更按内容哈希重新抽取,文件删除则同步移除。经验层仅检索,累积不影响上下文。
设计
.dsh-project-memory/
  format.json      布局标记(v2,分片式)
  shards/          每个被索引源文件一个自描述 JSON
                    ({ relPath, record, entries })——写入只落脏分片
  experience.json  问题 → 方案笔记(仅检索)
  watch.json       被监听根目录
  tasks.json       TaskBridge 任务实体(跨会话)
  binding.json     当前会话 ↔ 任务绑定
  insights.json    v0.5 项目级 insights(教训/决策/流程);v0.4 经验笔记非破坏导入一次
  injection-audit.jsonl   每次真实注入一行(注入了什么 / 为什么 / 丢了什么 / 额度)
  admission-shadow.jsonl  **每步**一行,全部被评分的候选 + 特征(离线重放、训练样本)
v0.2.0 之前创建的库(单文件 entries.json / index.json)在首次加载时自动幂等迁移。同一个 dsh 进程内,所有工具调用共享每个项目的单一内存 store 实例,热路径索引只写发生变化的那一个分片。
- 增量 — 按文件内容哈希,仅重新抽取变更文件。
- 交叉链接 —
query_memory返回文档 chunk 时,按当前符号表解算它提到的符号,以references带出。链接在读取期解算、不落盘,因此不会过期(文档先索引、符号后到也能链上),也不占存储。 - 查询扩展 —
llmQueryExpansion开启时,query_memory让ctx.llm将查询改写为多个变体(同义词、中英、符号名猜测),再跨变体合并 BM25 分数;关闭时查询完全不碰 LLM。索引本身不调用模型:keywords 由规则推导(标题加权词项),doc↔symbol 链接也会从中文命中带出英文符号名。 - 一致性 — 事实层跟随代码库(哈希重抽 / 删除即移除);经验层仅检索,配合覆盖与
forget机制。每个记忆目录的写入走同步事务store.commit(fn):fn 内完成校验与变更、成功后才原子落盘,单进程内天然串行;请避免多个 dsh 实例同时写同一项目存储。
架构(任务面板)
TaskPanel (Container)
├── task-data-store  (服务端数据,跨标签页 BroadcastChannel 同步)
├── task-ui-store    (本地 UI 状态,localStorage)
├── task-hooks       (useTaskDrag, useTaskEdit)
└── TaskComponents   (MiniBar, TaskCard — 纯展示组件)
工作流卡片可收起,自动适应 dsh 及主题插件风格,提供四种卡片风格切换。
配置
| 键 | 默认值 | 含义 |
|---|---|---|
memoryDir |
.dsh-project-memory |
每个被索引根目录内的存储目录 |
chunkChars |
3000 | 每个文档块最大字符数 |
maxChunksPerFile |
40 | 每文档最大块数 |
maxFileSizeMb |
50 | 大于该值(MB)的文档(含 PDF)/代码文件跳过 |
maxOutputChars |
8000 | query_memory 返回文本上限(字符) |
tasklist.enabled |
true | 启用 TaskBridge 自动同步(由会话 todo 清单与文件读取沉淀任务实体) |
tasklist.syncHostOnAdopt |
true | select_task//task switch 绑定任务时,将其 steps 推给宿主 todo/write,使 dsh 任务清单镜像任务实体 |
maxPdfPages |
1000 | 未另行限制时 PDF 的页数上限 |
llmQueryExpansion |
false | BM25 检索前通过 ctx.llm 扩展查询(默认关闭,节省 token) |
expansionCount |
6 | 扩展变体上限 |
lazyIndexing |
true | 模型读取文件的瞬间即索引(fs/observed) |
autoIndexOnFirstUse |
false | 插件加载时对当前工作目录做全量扫描(可选) |
watch |
true | 启用后台刷新 |
watchInterval |
30 | 基础轮询间隔(秒);空闲时逐步退避到最长 2 分钟,一有变化立即回到该值 |
maxScanFiles |
20000 | 单次扫描的文件数硬上限;被截断时会在报告里说明,且不会删除没扫到的条目。设 0 取消上限 |
maxScanDepth |
12 | 单次扫描的目录深度硬上限。设 0 取消 |
allowUnsafeRoots |
false | 允许显式工具调用(带 root 的 index_repo/watch_repo/remember)指向排除名单上的目录。自动路径(懒索引、会话审计、TaskBridge、autoIndexOnFirstUse)无论此项如何都不会越权 |
tsPath |
(自动) | 可选:强制指定特定 typescript 安装路径;省略时按项目 cwd → 插件 node_modules 向上解析 |
enableTypeScript |
true | 设为 false 彻底禁用 L2 TS 增强(仅保留 L1 正则) |
记忆与注入旋钮
| 键 | 默认值 | 含义 |
|---|---|---|
insight.* |
dedupOverlap 0.7 · reinforceBand 0.65 · maxProject 100 · maxGlobalProcedures 200 · promoteConfidence 0.7 · globalPromoteTasks 3 · decayDays 90 · globalFile(自动) |
v0.5 insight 去重/强化/提升/容量/归档设置 |
reflection.enabled |
false | v0.5 LLM 反思,只写任务级草稿(触发于任务切走/归档)。cooldownMs 1800000、maxLessonsPerReflect 3、maxDecisionsPerReflect 2 |
autoContext.enabled |
true | v0.5 静默注入包装(entry 常驻块 + relevance)。宿主无法解析会话 cwd 时完全透传(零副作用);maxTokens 400、editedMax 3(resident 任务卡显示最近"编辑中"文件数)、signalMinRatio 0.5(提示至少要达到该层最高分的一半)、skipEchoSelfTodo true(模型自己写/维护任务清单后、无新人类消息时不回声任务卡,省 token;相关 insights 仍注入)、budgetLog off(预算丢弃审计写到 stderr:off 静默 / once 每会话最多一行 / all 丢弃组合每变化一次一行。注入按优先级排程,预算不够时丢掉低优先级条目属于正常降级而非故障,所以默认不占用用户终端)、reinjectItemsAfter 0(同一条 insight 重复注入的冷却步数;0 = 正文没变就不在本会话内再注入——注入消息留在会话历史里,重发只是重复占位)、rootNotice true(记忆根是从无标记的工作目录推定出来时,向模型通告一次根在哪、怎么改) |
autoContext.gateCooldownSteps |
2 | 准入旋钮:两次条目注入之间至少隔几步(常驻任务卡不受限——它是状态快照,内容变了就该更新)。这是"别频繁注入"的主旋钮 |
autoContext.maxItemsPerSession |
60 | runaway 保险丝,不是节流阀 —— 节流由 maxTokens(单轮)与 gateCooldownSteps 负责。它是每会话硬上限:一旦触顶,本会话余下部分条目通道持续沉默。0.5.14 之前默认 12,而真实用量确实到得了(实测最长会话 35 条),于是长会话的后段被永久致盲。配小值可复现旧行为 |
autoContext.maxItemCharsPerSession |
24000 | 同上,按字符计 |
autoContext.hintMinCoverage |
0.45 | 提示通道的绝对下限:条目覆盖了查询多少 IDF 加权信息量。只用相对阈值分不出"有信号"和"矮子里拔将军"(实测无关条目也拿 relative:1.00)。0.5.8 从 0.30 上调:真实 43 条 store 上对照组以 cov 0.32~0.35 注入了 3 条无关提示——同源语料会把 IDF 分辨力拉平 |
autoContext.hintMinMatched |
2 | 提示还必须至少共享这么多个词:单个通用词("插件")不构成证据 |
autoContext.hintMinSupport |
0.15 | 通道级沉默:查询里能在语料中找到对应的词占比低于此值时,提示通道本轮整体不出声——否则一句只碰巧共享一个词的长句子会报出 cov:1.00 |
autoContext.legacyScope |
filter |
旧 trigger.scope 的处理:filter 保留旧语义,ignore 丢弃。npm run selfcheck:triggers 会列出 scope 值与项目画像 tag 空间不可能相交的条目 |
autoContext.auditLog |
true | 每次真实注入往 <root>/.dsh-project-memory/injection-audit.jsonl 追加一行(注入了什么、为什么命中、丢了什么、会话额度快照);超过 auditMaxBytes(262144)轮转 .1。任何 IO 失败都静默,绝不影响宿主请求 |
autoContext.shadowLog |
true | 每步(含什么都没注入的步)往 admission-shadow.jsonl 追加一行:排名靠前的被评分候选(rel / coverage / matched / decision / outcome)+ 场景(query / scoreQuery / ops / writes)。它让"换个阈值会怎样"可以在真实历史上离线回答(decision 指出每条候选卡在哪一关,outcome 指出预算拿它怎么办)。超过 shadowMaxBytes(524288)轮转,只保留一代 .1,所以单项目日志硬上限 ≈ 2 × shadowMaxBytes + 2 × auditMaxBytes ≈ 1.5 MB。只写盘,不进 prompt、不花 token |
autoContext.shadowMaxBytes |
524288 | admission-shadow.jsonl 的轮转上限(保留一代 .1) |
注入的准入化(为什么它保持安静)
自动注入过去是个检索问题("哪条记忆和这段文本最相关")——而检索是全函数,排序永远有答案,所以噪声是结构性的。现在它是个准入问题("这一步是否即将跨过我踩过坑的边界"),默认沉默:
- 只有
when能触发,且是低维的类型化信号:归一ops、这一步要写的文件、剥离引用之后的人类意图词。语料(原始工具参数、文件正文、文件名)永远不能触发任何东西。 guard只收窄。扩展名/泛名 glob(*.pptx、README*)被硬性忽略:它们只能撒谎,不能收窄。- 相对分 + 绝对下限。提示通道要同时满足相对分、IDF 加权覆盖率下限、以及至少两个共同词——
relative:1.00也会出现在和这一步毫无关系的条目上。 - 频率有上限。每
gateCooldownSteps步最多一次条目注入,每会话还有条数与字符上限;常驻任务卡不受限(它是快照),预算是上限不是目标。 - 前缀缓存纪律。注入以 user 消息追加在历史尾部,缓存前缀永不被改写;它带来的是常驻的 cache-read token,不是缓存失效;没有任何内容被原地改写。
- 可审计。每次真实注入往
injection-audit.jsonl落一行(原因、被丢弃的候选、会话额度);admission-shadow.jsonl再每步落一行(包括"正确地什么都没注入"的步),带全部候选的特征与卡在哪一关。后一个文件才是"阈值问题可以离线回答、而不是重跑 agent"的前提。npm run eval:injection在合成池上跑 8 个标注场景——当前精确率 1.00 / 召回率 1.00,对照组零注入;那个池子是 CI 基线,不是你数据的证据。把同一套 harness 指向你自己的 store(--store),对照组就变成硬闸门(失守则退出码非 0)——0.45 这条底线就是这么选出来的,你也可以用--hint-cov <n>换一条底线重放。
功能开关
两个最常用的开关是 lazyIndexing(模型读取文件的瞬间即索引;默认开启)和 autoIndexOnFirstUse(插件加载时对当前工作目录做全量扫描;默认关闭)。懒加载建立的索引根会自动注册到 watcher,文件变更无需手动 watch_repo 也能保持新鲜。
项目根怎么定。 按顺序:显式 root 参数 → 登记的根(watch_repo)→ 最近的 VCS 标记(.git/.hg/.svn)或构建/清单标记(package.json、go.mod、Cargo.toml、pyproject.toml 等)所在祖先 → 会话工作目录(前提是它不在排除名单里)。都不命中则不索引该文件。
根来自工作目录时,模型每个会话收到一条通告,说明根的位置与改法;autoContext.rootNotice: false 关闭。因此在 ~/workspace 这类容器目录里启动 dsh,该目录就是根,记忆覆盖其下所有项目直到扫描上限——想一个项目一个 store,就在项目目录里启动。
排除名单。 以下目录不会作为根,精确匹配(子目录不受影响):文件系统根、家目录、临时目录(os.tmpdir() 与共享的 /tmp、/var/tmp、%TEMP%、%SystemRoot%\Temp),以及系统/包管理器前缀(POSIX 上的 /opt/homebrew,Windows 上的 %SystemRoot%、%ProgramFiles%、%ProgramData%)。这些目录下的会话不启用记忆,stderr 输出一行说明。
扫描上限。 单次扫描最多 maxScanFiles 个文件(20000)、maxScanDepth 层目录(12)。被截断时,index_repo 的结果里会说明,watcher 每个根记一行,且不会删除没扫到的条目。目录树更大就调高这两个值。
store 建在被索引的目录树里,并且自我忽略:它在自己目录内写入一条 * 规则(<store>/.gitignore)。git 会读取任意目录下的 .gitignore,所以 git status / git add -A 里都看不到它,你自己的 .gitignore 一个字都不用加(git clean -fd 也因此不会删它)。确实想把记忆跟着仓库提交:git add -f .dsh-project-memory——已跟踪的文件不受忽略规则影响。
配置存放在插件的 config 对象中。修改方式:在 profile 的 cordis.patch.yml 里加一条覆盖项——web profile 对应 ~/.dsh/profiles/web/cordis.patch.yml:
- id: project-memory
  config:
    lazyIndexing: true          # 开启:模型读到哪个文件就索引哪个(默认)
    autoIndexOnFirstUse: false  # 关闭:不做加载时的全量扫描(默认)
    llmQueryExpansion: false    # 关闭:不用 LLM 扩展查询,节省 token(默认)
    watch: true                 # 开启:被监听根目录后台保持新鲜(默认)
    watchInterval: 30           # 基础轮询间隔;空闲时退避到最长 2 分钟
    maxScanFiles: 20000         # 单次扫描文件上限(截断会报告,且不会误删旧条目)
    maxScanDepth: 12            # 单次扫描目录深度上限
    enableTypeScript: true      # 开启:装了 TS 时启用 L2 语义增强(默认)
    # allowUnsafeRoots: false   # 保持 false,除非你确实要显式索引家目录/系统目录
    # budgetLog: once           # 调试用:注入被预算挤掉时在 stderr 留痕(默认 off 静默)
    # reinjectItemsAfter: 20    # 调试用:同一条 insight 隔 N 步才允许重发(默认 0 = 本会话只发一次)
    # tsPath: /custom/path/to/typescript  # 可选:强制指定 TS 安装路径
只需列出要改的键,其余键回落到插件默认值。用 dsh --profile web --dump-config 验证生效。
不想改 profile 文件、只想临时试一次,可用 CLI 补丁覆盖:
dsh web --patch ./config.yml
其中 config.yml 内容就是上面的覆盖块。
性能
真实项目实测(2026-09-25)
四个语料、同一台机器(Node 24.19,20 vCPU,Linux 文件系统),每个跑两遍、引用**第二次(页缓存已热)**的数据。「冷索引」= 完整索引一轮(walk + sha256 + 抽取 + 落盘);「查询」= 线上同一套 scorer 跑 100 条采样;「单文件重索引」= watch / 懒索引热路径。
| 语料 | 文件数 / 条目数 | 冷索引 | 冷加载 | 查询 p50 / p95 | 单文件重索引 | 存储内容 / 落盘 | 加载后堆 |
|---|---|---|---|---|---|---|---|
| Vue 3 + Vite 应用(纯代码) | 289 / 2,142 | 283 ms | 5.2 ms | 0.86 / 1.8 ms | 0.4 ms | 0.66 MB / 1.52 MB | 6.1 MB |
| 文档 + PDF 工作区(274 篇文档) | 286 / 2,120 | 6.5 s | 12.4 ms | 4.6 / 13.9 ms | 0.4 ms | 3.05 MB / 3.63 MB | 9.0 MB |
| TypeScript monorepo,3,000 文件切片 | 3,000 / 17,733 | 2.1 s | 59 ms | 10.2 / 21.4 ms | 1.8 ms | 11.0 MB / 19.0 MB | 22.6 MB |
| TypeScript monorepo,整棵树 | 12,408 / 79,168 | 8.6 s | 239 ms | 45.8 / 89.3 ms | 7.4 ms | 41.7 MB / 74.7 MB | 73.9 MB |
扩展形状。 重索引一个变更文件的成本是 O(文件)、不是 O(语料)——上面每个语料都在 0.4–7.4 ms。冷加载(≈19 µs/文件)、查询(≈0.6 µs/条目)与常驻堆(首次查询物化 searchText 后 ≈1.4 KB/条目)随索引规模线性增长,因此小型与中型项目都落在个位数毫秒。
两条口径说明:
read+hash受操作系统页缓存影响(12.4k 文件时冷缓存 2.5 s、热缓存 0.3 s),所以引用的是热缓存那一遍;同一台机器上跨天跑同一基准会有约 20% 以内的漂移,请只比较同一会话内测出的数字。
合成基准测试(Node 24.19,20 vCPU,Linux 文件系统)
| 场景 | 规模 | 实测 |
|---|---|---|
| 批量冷记忆构建 | 5,000 文件 / 20k 条目 | 373 ms 均值(p50 374) |
| 冷加载 | 5,000 文件 | 56 ms |
| 热路径懒记忆 | 单文件重记忆+落盘 | p50 2.8 ms / 最大 3.5 ms (5k) |
| query_memory (缓存命中) | 5k 文件 / 20k 条目 | p50 3.3 ms / p95 6.9 ms |
| query_memory (缓存命中) | 1k 文件 / 4k 条目 | p50 0.7 ms / p95 1.5 ms |
| 批量冷记忆构建 | 10,000 文件 / 40k 条目 | 696 ms 均值(p50 668) |
| 冷加载 | 10,000 文件 | 123 ms |
| 热路径懒记忆 | 单文件重记忆+落盘 | p50 5.9 ms / 最大 13.5 ms (10k) |
合成基准:生成代码(~4–5 符号/文件),Node 24.19 / 20 vCPU / Linux 文件系统,实测于 2026-09-25。复现命令
npm run bench:synthetic -- 5000(脚本scripts/bench-synthetic.mjs)。测量纯索引开销,不含 LLM 调用。query_memory 使用 IDF 缓存 + 首次使用时物化 searchText;写入后的首次查询会重建 IDF(40k 条目 142 ms,20k 条目 67 ms,4k 条目 14 ms),后续查询命中缓存。
自己复现这些数字
与其让你相信上面的表格,不如把测量本身一起发布——它随仓库发布,也随 npm 包一起发布(scripts/ 已包含在 tarball 中)。脚本不需要 dsh 实例、不需要网络、不调用任何模型,也不碰被测项目自己的 store——结果写进临时目录,跑完删除:
npm run bench -- /你的/项目路径
# 或带参数:
node scripts/bench.mjs /你的/项目路径 [--json] [--samples 100] [--no-pdf] [--keep]
输出包含:冷索引(拆成 read+hash / extract / commit 三段)、冷加载、IDF 重建、冷查询与热查询延迟(走线上同一套 scorer,100 条采样报 p50/p95/max)、单文件热重索引、存储内容与落盘体积、常驻堆(加载后与首次查询后)、单条目字节数。示例——上表里的 Vue 应用:
冷索引     283 ms   (read+hash 11 ms · extract 256 ms · commit 14 ms)← 第二次、页缓存已热
存储       内容 0.66 MB · 落盘 1.52 MB · 325 bytes/条目 · 冷加载 5.2 ms
内存       加载后堆 6.1 MB → 首次查询后 6.7 MB(RSS 62 MB)
热查询     p50 0.86 ms · p95 1.8 ms          (2,142 条目)
单文件重索引  p50 0.4 ms
带 --queries 你的查询集.json 可以在你自己的项目上跑标注集方法(hit@5 / hit@10 / MRR)。
设计取舍
- 同步无锁事务,而非异步锁 — 不加异步锁、文件锁或多进程协调:DSH 基于 Cordis,单进程是架构基石,为极少见的多进程场景加锁只会让热路径(每次
remember/forget/index_doc)增重;同步事务下热路径中位数 ~2 ms,零争用。 - Watch:事务外计算,事务内提交 — 不持锁解析、也不用
fs.watch:解析与 PDF 抽取很慢,持锁会阻塞查询;轮询 + mtime/内容哈希在网络盘、Docker 卷、WSL 上行为一致,没有fs.watch的重复触发/漏事件问题。 - 损坏分片隔离,不自动修复 — 解析失败的 JSON 改名
*.corrupt、该文件重头开始,其余分片不受影响;不引入 WAL 或嵌入式数据库:那要多 500 KB+ 原生依赖、锁竞争,以及一个新故障模式(WAL 自身损坏),而代价只是丢一个文件的索引。 - 查询零向量、零语义搜索 — 不引入嵌入模型、向量索引(HNSW/IVF)或重排序:在本插件针对的查询上词法检索已经够用——真实 Vue 项目 29 条标注查询的文件级 hit@5 为 96.6%,整 chunk
terms把文档词项覆盖从 27.3% 提到 100% 且 MRR 不变(0.958 vs 0.955)。边际收益不抵 10x 复杂度/成本;方法随代码发布,scripts/bench.mjs --queries 你的查询集.json可在你自己的项目上复现。 - 索引确定且不调用模型 — 索引期不调模型、查询期也不翻译:前者会让同一份文档两次索引结果不同,后者有一个硬失败模式(译错 = 零召回);规则 + 符号链接已经覆盖常见情况,且离线可用。
- 面向模型的记忆:agent 自己写,不把人放进回路 — 不要求人工批准:记忆的消费方是 agent,而 agent 通常是无头的,只在有人点卡片时才升级的记忆等于永远不会升级。
draft是「来源标记 + 佐证门槛」而不是审批队列——唯一的推断型写入者reflection(默认关闭)只写任务级草稿,草稿不进召回与注入。 - 直接返回完整条目 — 条目本就紧凑,完整返回更可核验,也少一轮往返。
forget按关键词激进;精确请用 ID — 不做确认弹窗、回收站或仅精确匹配:经验笔记低风险、高量、仅用于检索,陈旧噪音比误删更伤。精确删用query_memory输出里的 ID。- TS 增强可选、异步、缓存 — L2 TS Compiler API 在优先级队列异步跑(P0
fs/observed、P1watch、P2index_repo),结果按内容哈希缓存;不强制 TS、也不阻塞索引:强制会让非 TS 项目装不上,阻塞会卡死大项目的index_repo;npm i -D typescript@5|6即自动启用,没有 TS 时回退 L1 正则。默认 lib 不加载(编译期noLib):依赖全局类型(Promise/Array/DOM)的推导会退化成any/unknown,显式标注的类型不受影响。 - 子代理会话暂不纳入(以后可能做)
开发(面向贡献者)
以下命令用于维护插件源码,普通用户无需执行。安装插件只需使用安装一节中的命令。
npm install
npm test                    # 561 项测试(核心 216 + TaskBridge 16 + insight-store 12 + insight-actions 9 + doc-index 8 + auto-inject 7 + host-contract 10 + reflection 5 + llm-route 5 + client-hints 2 + recall 10 + readiness 15 + insight-derive 7 + readiness-eval 7 + ops 6 + injection-audit 12 + injection-budget 10 + injection-scenarios 6 + bugfix-0.5.7 18 + client-icons 3 + client-slash 10 + client-toolview 5 + workflow-command 5 + client-session-id 7 + task-view 7 + root-guards 79 + store-gitignore 9 + atomic-write 6 + store-cache 22 + enhancer 27)
npm run eval:injection      # 合成池上的场景 P/R:命中 14/14、假阳性 0、对照组零注入
npm run eval:injection -- --store .dsh-project-memory/insights.json   # 用你自己的 store 重放;对照组是硬闸门
npm run selfcheck:triggers  # 哪些条目还推得动、哪些声明是死的(读你本地的 store)
npm run bench -- /你的/项目路径   # 对任意项目量索引/查询性能,不需要 dsh
发布说明见 CHANGELOG.md 与 GitHub Releases。
许可证
MIT,全文见 LICENSE。
Copyright (c) 2026 00080000 <3388065969@qq.com>
链接
同类插件
vectorize-io/hindsight#coding-agents★ 45151
Hindsight:会学习的 Agent 长期记忆系统,自动召回/保存、知识页、深度反思与按仓库隔离的记忆银行。
volcengine/OpenViking#examples/dsh-memory-plugin★ 39169
面向 DeepSeek Harness 的 OpenViking 记忆与上下文插件:pre-step 自动召回与画像注入、会话捕获、`viking://` URI 防护,以及对接 OpenViking 服务端的 recall/write 记忆工具。
agentscope-ai/ReMe#dsh★ 3548
将 DeepSeek Harness 接入 ReMe 本地优先、自进化的个人知识库:自动把已完成的主 Agent 对话沉淀为用户掌控的 Markdown 记忆,通过 reme_search 结合 BM25、可选向量检索和 wikilink 展开搜索对话与资料,并按日整理长期记忆。
zilliztech/memsearch#MemSearch★ 2711
供 DSH 与其他编程 Agent 共享的 Markdown 记忆,支持自动捕获、步骤前上下文注入、搜索召回,以及通过审阅面板实现 memory-to-skill 自进化。
vshulcz/deja-vu#extensions/dsh★ 1127
读取本机上其他三十三个编程智能体已经写下的会话文件——Claude Code、Codex、Cursor、VS Code Copilot Chat、opencode、OpenClaw、Hermes、Kimi、Cline、Zed 等,包括安装之前的历史:提供 deja_recall、deja_session、deja_blame、deja_fix、deja_how、deja_remember 六个工具与 /deja 命令,并可选地把召回结果加入运行时上下文。本地 BM25 索引,不用大模型,不用向量嵌入,不联网(dsh plugin --profile web add dsh-deja)。
adoresever/graph-memory★ 636
DeepSeek Harness 的可追溯、可检索跨会话记忆:把对话知识沉淀为带类型的图节点(任务/技能/事件)与关系边。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。