llama-cpp qwen3.8-27b 低上下文时,强制上下文压缩插件,提示模型使用效率和使用流畅度,外加完善的压缩提示。
安装
# npm 包(预构建)
dsh plugin --profile web add @falling-ts/dsh-force-compact
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:falling-ts/dsh-force-compact
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
面向 DeepSeek Harness agent 的激进、本地优先上下文压缩。
一个 DSH Cordis 功能插件,让 agent 的工作上下文始终保持精悍:用自建 llama.cpp 以
适中上下文承载 Qwen3.8‑27B,插件负责收缩会话本身——近乎大窗口的体验,无 API 费用、
数据不出本机。
为什么要做
- 本地推理——agent 走标准 DeepSeek 适配器对接一台本地 OpenAI 兼容的 llama.cpp 服务端,无需另行编写适配器。
- 低上下文、高信号——不与小上限较劲,而是直接收缩会话:agent 在短促的请求上 思考,同时靠压缩后的开头段保有深层记忆。
- 只关压缩的思考,其余放行——
disableThinking: true(默认)只关掉 本插件自己的压缩摘要调用 的思考;其他一切模型请求沿用机器原有配置,原样放行。 - 私密免费——不计 token 费用,无数据外流。
它能做什么
两条压缩引擎经由统一门面(resolveCompaction)共存,对调用者透明:
| 引擎 | 启用条件 | 说明 |
|---|---|---|
| 官方 | agent 领域内可解析出 compaction 服务 |
优先;委托 compaction/basic。 |
| 内置 | 自动回落(典型标准预设将服务隔离,解析不到) | 基于 ctx.sessions / ctx.llm.stream / ctx.tokenMeter 的自包含持久事务;复用官方 compaction/* 事件词汇,跨版本回放安全。 |
无需切换——官方可达就走官方,不可达就内置接管。
触发点
- 每次请求门禁(
agent/pre-step)——读取会话预计上下文 token(即界面右下角显示的 数字)。达到autoThresholdTokens时,拒绝本次出站请求并改压缩头部,最近retainLatestTokens逐字保留;低于阈值则请求照常进行。 - 回合结束 / 静止(
agent/status→idle)——agent 静止时(含子代理全部结束), 可选地经compactNow压缩(开关:turnEndForceCompactionEnabled)。 - 手动
/force-compact——对忙/闲 agent 都能生效:空闲立即压缩;繁忙则排队一个 进程内强制标记,在下一个模型步骤消费。命令本身惰性加载——见安装章「命令可用性」。 在/菜单里这一行与官方一等公民命令同款外观:图标 + 本地化名称 + 本地化描述(官方的 外观表只覆盖一等公民命令,故由本插件客户端半部自己贴面——见AGENTS.md「指令行的官方外观」)。 session/flush——等待型的持久化检查点。
每条路径最终都汇入唯一的「压缩结果落入会话」边界——也正是发送 LiveUI 信令的位置。
判定键用 projectedTokens(provider 锚定,与界面角标同源),故插件永远不会偏离你所见;
触发后循环压缩(2026-09 语义):自动门禁、/force-compact、回合结束两条路径会在同
一次触发内反复压缩,直到 projectedTokens 压回 autoThresholdTokens 以下,或表面
已无可压缩头部(整个表面都不超过 retainLatestTokens 保留预算)为止;单轮"压缩后仍
≥ 阈值"不再被跳过(旧版的 threshold-aware shrink-gate 已移除,它把 provider 压力基线
计入判定,baseline 偏高时会令可压缩会话滞留超阈值)。硬上限
MAX_COMPACTION_ROUNDS=8 兜底,防止 provider 基线异常时无限烧摘要调用。真正"物理防呆"
的拒绝保留不变:摘要必须显著小于被遮蔽区间(post-summary shrink gate,防膨胀)、
小于 MIN_USEFUL_SPAN_TOKENS 的小头部不浪费摘要调用、replay 消息上限、失败冷却、
busy 锁与表面一致性校验。
内置事务的影子价格账单取自与官方引擎相同的 tokenMeter.measure 逐节点单价,故米表
折叠协议结算正确——压缩后右下角计数器下降,而非漂移上升。
思考控制:只作用于压缩
自 2026‑08 语义修订,disableThinking 只管一件事:本插件自己的摘要调用
(engine/builtin.js → engine/summarizer.js → ctx.llm.stream)是否携带
reasoningEffort:'off'。其余一切不受影响:
| 调用位置 | disableThinking: true 时的行为 |
|---|---|
| 内置引擎的摘要调用 | 携带 reasoningEffort:'off' |
| 其他一切模型请求(业务、子代理、工具、其他插件) | 机器 LlmCallConfig 原样不动 |
官方 compaction 服务的调用 |
不经过本插件任何接缝——不受影响 |
目标是 llama.cpp / OpenAI 兼容端点时,适配器吐出的 thinking: { type: 'disabled' }
字段在那里被静默忽略——所以摘要器另外打上 llama.cpp 原生顶层字段
reasoning_effort: "none",门控条件与前一字完全一致。同一 options 对象携带两字段:
| 端点家族 | 读取 | 结果 |
|---|---|---|
| 真·DeepSeek API | reasoningEffort:'off' → thinking:{type:'disabled'} |
关思考 ✅ |
| llama.cpp / OpenAI 兼容 | reasoning_effort:"none"(顶层) |
enable_thinking=false ✅ |
每一类端点都宽容无视对方家族的键,故双发无害。字段打在 src/engine/summarizer.js
(紧挨 llm.stream(options) 调用之前),不在 llm/stream 瀑布里——早期草稿曾在那
处尝试注入,实证证明结构性无效(中间层返回值被丢弃;就地改种子会使宿主崩溃);论证全文
见 src/hooks/wire-rewrite.js 模块头部。该钩子现在只承担 LiveUI 水印角色。
业务调用也要关思考?在请求头层面设定你 provider 的 reasoningEffort——插件有意退出
该决定。
可观测性:每次摘要尝试的审计行
每次摘要尝试都会打两行日志(默认 debug: true 即见)——不抓包就能确认作用域裁定与其
wire 字段的持久证据:
[force-compact] <sessionId>: compaction thinking-policy — settings.disableThinking=true → extra.reasoningEffort='off' (this summarization call carries thinking-OFF)
[force-compact] <sessionId>: summarization wire-fields → <provider>/<model>: reasoningEffort='off' + reasoning_effort="none" (llama.cpp-native wire field)
- 第一行(
engine/builtin.js)记录disableThinking在哪里被读出、如何进入调用 选项;关闭时则记录沿用机器默认。 - 第二行(
engine/summarizer.js)记录离开 options 对象那一刻的两个 wire 字段(加上 解析出的 provider/模型);未盖章字段标注(absent…)。
实证背书:对本机 llama.cpp 端点做过对照——基线请求返回非空 reasoning_content
(默认会想),带顶层 reasoning_effort:"none" 的同款请求完全没有——该类端点上该字段
确实在关思考,而未携字段业务调用维持正常思考。
LiveUI 状态
极小的宿主→客户端信道(liveUi 设置字段被实时镜像到浏览器)替换官方运行标签的前缀——
只动文字:harness 自己的计时文本、字体、颜色原样不动。
[强制压缩中>>>]——压缩即将提交前;[压缩完成!]——压缩结果落定的瞬间;约 3 秒后,一条新鲜的随机工作中短句接替;- 轮换的俏皮短句——平时每次模型请求都换一条;
- 会话结束「还原」——agent 转入 idle(一轮彻底结束)时推一个空文本(isImportant): 客户端把官方原文放回去并撤掉替换前缀。取代 2026-09 前的"会话开始时强制重绘随机工作态"。
harness 0.2.0 把这行运行态文案搬进了独立组件 RunningStatus(0.1.7 时的
button[data-turn-process] > span 现在只渲染已结束回合),锚点是容器属性
data-chat-running。结构如下:
<div data-chat-running>
  <span role="status" aria-live="polite">深度求索中</span>        ← 1px 裁剪的读屏播报
  <span .runningDivider>                                          ← 分隔线
  <span .runningContent>
    <span .runningIcon>…鲸鱼动画(APNG mask + SVG 兜底)…</span>    ← 前缀动画小图标
    <TextShimmer data-shimmer>深度求索中,用时1分14秒 ···</TextShimmer>
  </span>
</div>
客户端半部只替换那句文字的前缀:拿 role="status" 播报节点的文本当锚,按两者的
公共前缀切开原文,其余部分——harness 的计时尾巴(含官方结尾的 ···)——逐字保留。
前缀的鲸鱼动画图标与分隔线原样保留,不写颜色、不改字体、不动布局;播报节点绝不触碰,
读屏器仍听到官方文案。
一个 MutationObserver(仅在有活跃相位期间连接)双写两处文字:TextShimmer 把同一句渲染了
两遍(真实文本节点 + 一份 aria-hidden 的动画高亮副本,后者的字由 CSS
::after { content: attr(data-shimmer-text) } 从属性取)——只改文本节点的话,扫光扫过时会
露出官方旧文案。观察器在 React 重写的同一微任务里重新贴上,所以计时继续走、且全程零轮询。
徽标文字跟随应用语言:宿主写入语言无关的 textId(相位名或 working.N)加规范中文文本,
客户端半部经自己的 ctx.locale zh/en/ja/ko 词典解析——英文界面显示英文俏皮话,中文界面
保持原文。
发送方绝对安全:信令故障绝不误伤真实的压缩事务。
工作原理
agent/request(payload, next)              # 每次模型请求
    return await next()                  # 纯透传(思考关闭只作用于本插件
                                          # 自己的摘要调用)

agent/pre-step(payload, next)             # 每个模型步骤前
    projectedTokens >= autoThresholdTokens?
        否  -> next()                    # 放行
        是  -> compactRegion(保留段之前的头部区间, signal)
               return { kind: "reject" } # 本步骤不请求模型

agent/status({ agent, status })          # 生命体征过渡
    status === "idle" && turnEndForceCompactionEnabled?
        -> compactNow(agent, 新signal)   # 回合结束压缩

session/flush(session)                   # 持久化检查点
    选取区间 -> 投影消息 -> 预览 + 缩容门禁
    -> compaction.compactRegion(start, end, agent, signal)
支撑模块:
src/hooks/guard.js—— 每次请求的门禁:agent/request纯透传(不再批量盖思考章)+pre-step阈值门 + 进程内强制标记(thinkingDisabled仅作遗留谓词保留,热路径不再 调用)。src/hooks/command.js——/force-compact命令(惰性注册)。src/hooks/idle.js—— 回合结束强制压缩。src/hooks/wire-rewrite.js——llm/stream的 LiveUI 水印钩子(不再做任何 wire 操作;缘由见模块头部历史注记)。src/engine/region.js—— 选区(锚定头/尾,含官方工具配对台账)。src/engine/summarizer.js—— 一次性 LLM 摘要器,与官方compaction-basic完全 对齐(三级 target 解析、前缀缓存对齐、purpose:'compaction'标签、fail-closed 终局分类、用量采集)。src/engine/builtin.js—— 内置持久事务(官方compaction/*词汇)。src/engine/checkpoint.js—— 预览 + 缩容门禁 + 委托压缩服务。src/core/projected.js—— provider 锚定的projectedTokens。src/core/ui-signal.js—— LiveUI 信道。
安装
作为安装包(推荐):
# 从 npm(已发布):
npm install @falling-ts/dsh-force-compact
# 从 git:
dsh plugin --profile web add github:falling-ts/dsh-force-compact
# 从本地检出:
dsh plugin --profile web add ./dsh-force-compact
或不安装,直接从本地检出以 --patch 覆盖层挂载:
dsh web --patch dsh-force-compact/cordis.patch.yml
插件加载 ⟺ ~/.dsh/logs/dsh-force-compact.log 新增一行:
[force-compact] debug logging enabled — writing [force-compact] lines to <absolute path>
命令可用性——/force-compact 是惰性加载的
commands 服务随 agent 预设平面到达,晚于插件启动期的 apply——所以注册发生在
第一次受守卫监听器激活时(agent/request / agent/pre-step / agent/status /
session/flush 任一),首次成功后永久闩闭。实际效果:实例(重新)启动后,全新会话的
/ 命令列表在该会话第一次模型请求之前不会出现 /force-compact——先发任意一条消息,
命令即进程级注册,此后所有会话可用。
- 成功:
[force-compact] /force-compact command registered (deferred) commands永久缺席:约 10 分钟后打一条… still UNREGISTERED 10 min …警告,解释 空列表。注册完成前插件其余功能照常——属自愈式降级,不是安装失败。
验证压缩确实发生:
idle compaction (builtin) shadowed N nodes (~M tokens)
builtin compaction OK — replaced span seq[A..B] (N nodes, ~K tokens) with a P-char checkpoint
compaction thinking-policy — settings.disableThinking=true → extra.reasoningEffort='off' (…)
summarization wire-fields → <provider>/<model>: reasoningEffort='off' + reasoning_effort="none" (…)
(最后两行即上文「可观测性」所述的那对审计行。)
设置
命名空间 falling-ts-force-compact(= profile 里该条目的 loader id),值写进 profile 的
cordis.patch.yml(harness 0.1.7 起;旧版是 $DSH_HOME/settings.yaml):
| 键 | 类型 | 默认 | 含义 |
|---|---|---|---|
disableThinking |
布尔 | true |
只有关闭时,本插件摘要调用不携带 reasoningEffort:'off';其余请求一律机器默认。 |
autoThresholdTokens |
数字 ≥ 32000 | 32000 |
门禁的默认预计 token 触发值:未设置会话级覆盖的会话一律用它。越低越激进,常驻请求越小。读取时不低于 32000(低于则抬高)。参见会话级阈值。 |
retainLatestTokens |
正整数 ≥ 8000 | 8000 |
从会话最新条目起保留的最新 token 数,逐字保留;更早内容一次性发往摘要。读取时不低于 8000。同时驱动自动门禁与 /force-compact。 |
turnEndForceCompactionEnabled |
布尔 | true |
agent 转入 idle 时压缩。 |
debug |
布尔 | true |
把 [force-compact] 诊断打到插件日志。实时生效(2026-09):开关在每一条导出日志时实时读取,改设置表单(或 profile 的 cordis.patch.yml)后下一行即生效,无需重启;logFile 路径在安装时固定,改路径需重启进程。 |
logFile |
字符串 | ~/.dsh/logs/dsh-force-compact.log |
诊断输出路径(~ 展开到家目录)。 |
compactionMode |
'realm' | 'global' |
'realm' |
官方服务解析策略(优先级一)。 |
builtinEnabled |
布尔 | true |
内置引擎回落闸门。 |
maxSummaryTokens |
整数(1024–200000) | 1024 |
摘要 LLM maxTokens 上限。 |
summarizationTimeoutMs |
整数 5000–2147483647(毫秒) | 90000 |
一次摘要流的硬墙钟超时上限(挂起流守卫)。读取时不低于 5000(过小的上限会误判慢速本地端点挂起);不高于 2147483647——该值经 AbortSignal.timeout 调度, 小数会直接抛错, 而 2^31..2^32-1 区间会被静默降成 1ms。超界值双向钳制, 小数截断。 |
示例——激进的本地档:
falling-ts-force-compact:
  disableThinking: true
  autoThresholdTokens: 40000   # 早压 ⇒ 常驻请求更小
  retainLatestTokens: 8000
  turnEndForceCompactionEnabled: true
settings 服务缺席时,插件回落到同样的默认值并照常压缩——命名空间可选,永不成为硬
依赖。
上表中涉及 token 计数的字段在设置表单里均支持 K / M 后缀
(32K、1M 或纯数字);按十进制解析(32K = 32000、1M = 1000000),上表的上下限依然生效。
下面的会话级控件用的是同一个解析器。
会话级阈值
autoThresholdTokens 只是默认值。单个会话可以覆盖它,而不必改动共享设置:
- 入口是输入框底部状态条里、上下文占用百分比右侧的 chip(与内置统计药丸同一行)。 它显示固定文案(图标 +「强制压缩阈值」),因此每一行看起来都一致、数字也不会挪动布局; 当前生效的阈值、所属会话与是否被覆盖,都放在悬停提示里(面板里也有)。
- 点击展开小面板:输入阈值后「保存」;或点「使用全局默认」清除覆盖。
- 输入接受纯数字或
K/M后缀(123K、1M、32000);按十进制解析 (32K= 32000,1M= 1000000),同样受 32000 下限约束。无法解析时内联报错并拒写; 清空输入即回落到默认值。 - 当
阈值 < 上下文窗口时,插件还会画出压缩会在哪里触发:圆环上按阈值 / 上下文窗口的角度画一个红色圆点(从 12 点起顺时针,与圆环填充同向); 展开面板的横条上按同一比例画一条红色竖线,高度恰好等于横条。阈值达到或超过 上下文窗口时不画——占用永远够不到它,也就不存在可标记的触发点。 - 值以会话 id 为键存在本命名空间的
sessionThresholds下,只对所属会话生效。 所有门禁(自动压缩、/force-compact、区域压缩、checkpoint、idle)统一按sessionThresholds[sessionId] ?? autoThresholdTokens解析。 - 「不存在」是有意义的:删掉键即恢复默认,覆盖不会被误当成全局改动。
- chip 在「性能与用量」的简洁与详细两种展示模式下都会出现; 内置统计药丸在无内容时会自行隐藏,阈值 chip 不会。
低上下文 llama.cpp 调优建议
autoThresholdTokens 保持在所供上下文的明显之内(例如以 80k–128k 舒适上下文供服,
就把阈值设在 40k):常驻请求小而延迟稳,agent 依旧靠压缩头段保有深层记忆。压力以
预计 token(provider 锚定)度量,阈值与你界面上看到的数字可预期对应。
行为说明
- 运行时依赖:
compaction服务(preset 平面agent-presets:compaction-basic), 经ctx.get('compaction')实时读取;不可用时回落内置引擎(或放行请求)。 - 可选依赖:
settings/tokenMeter/commands/llm/agents均经ctx.get(...)读取并守卫;缺任一都优雅降级而非崩溃。 - 每请求读参数: 参数每次模型请求读取,改动下次请求即生效,无需重启。
- 信号:
agent/*瀑布转发当前回合的信号;session/flush检查点与agent/status静止监听器各自新建AbortController。 - 持久化: 持久物为
compaction/*括号事件 + 一条surfaceOp:replace的user/message检查点,跨版本回放安全。 - 客户端半部:
web/client.js新增「强制压缩」设置分区(本地化标签),支持实时改 值(uSES 安全镜像),除一处有意保留的 3 秒定时器(纯表现层,见下)外无任何定时/状态。 - 唯一的有意定时器:
publishDone的 3 秒回落(表现层,见插件 AGENTS.md 例外节); 其余全部纯监听器 + 进程内Map强制标记。
截图
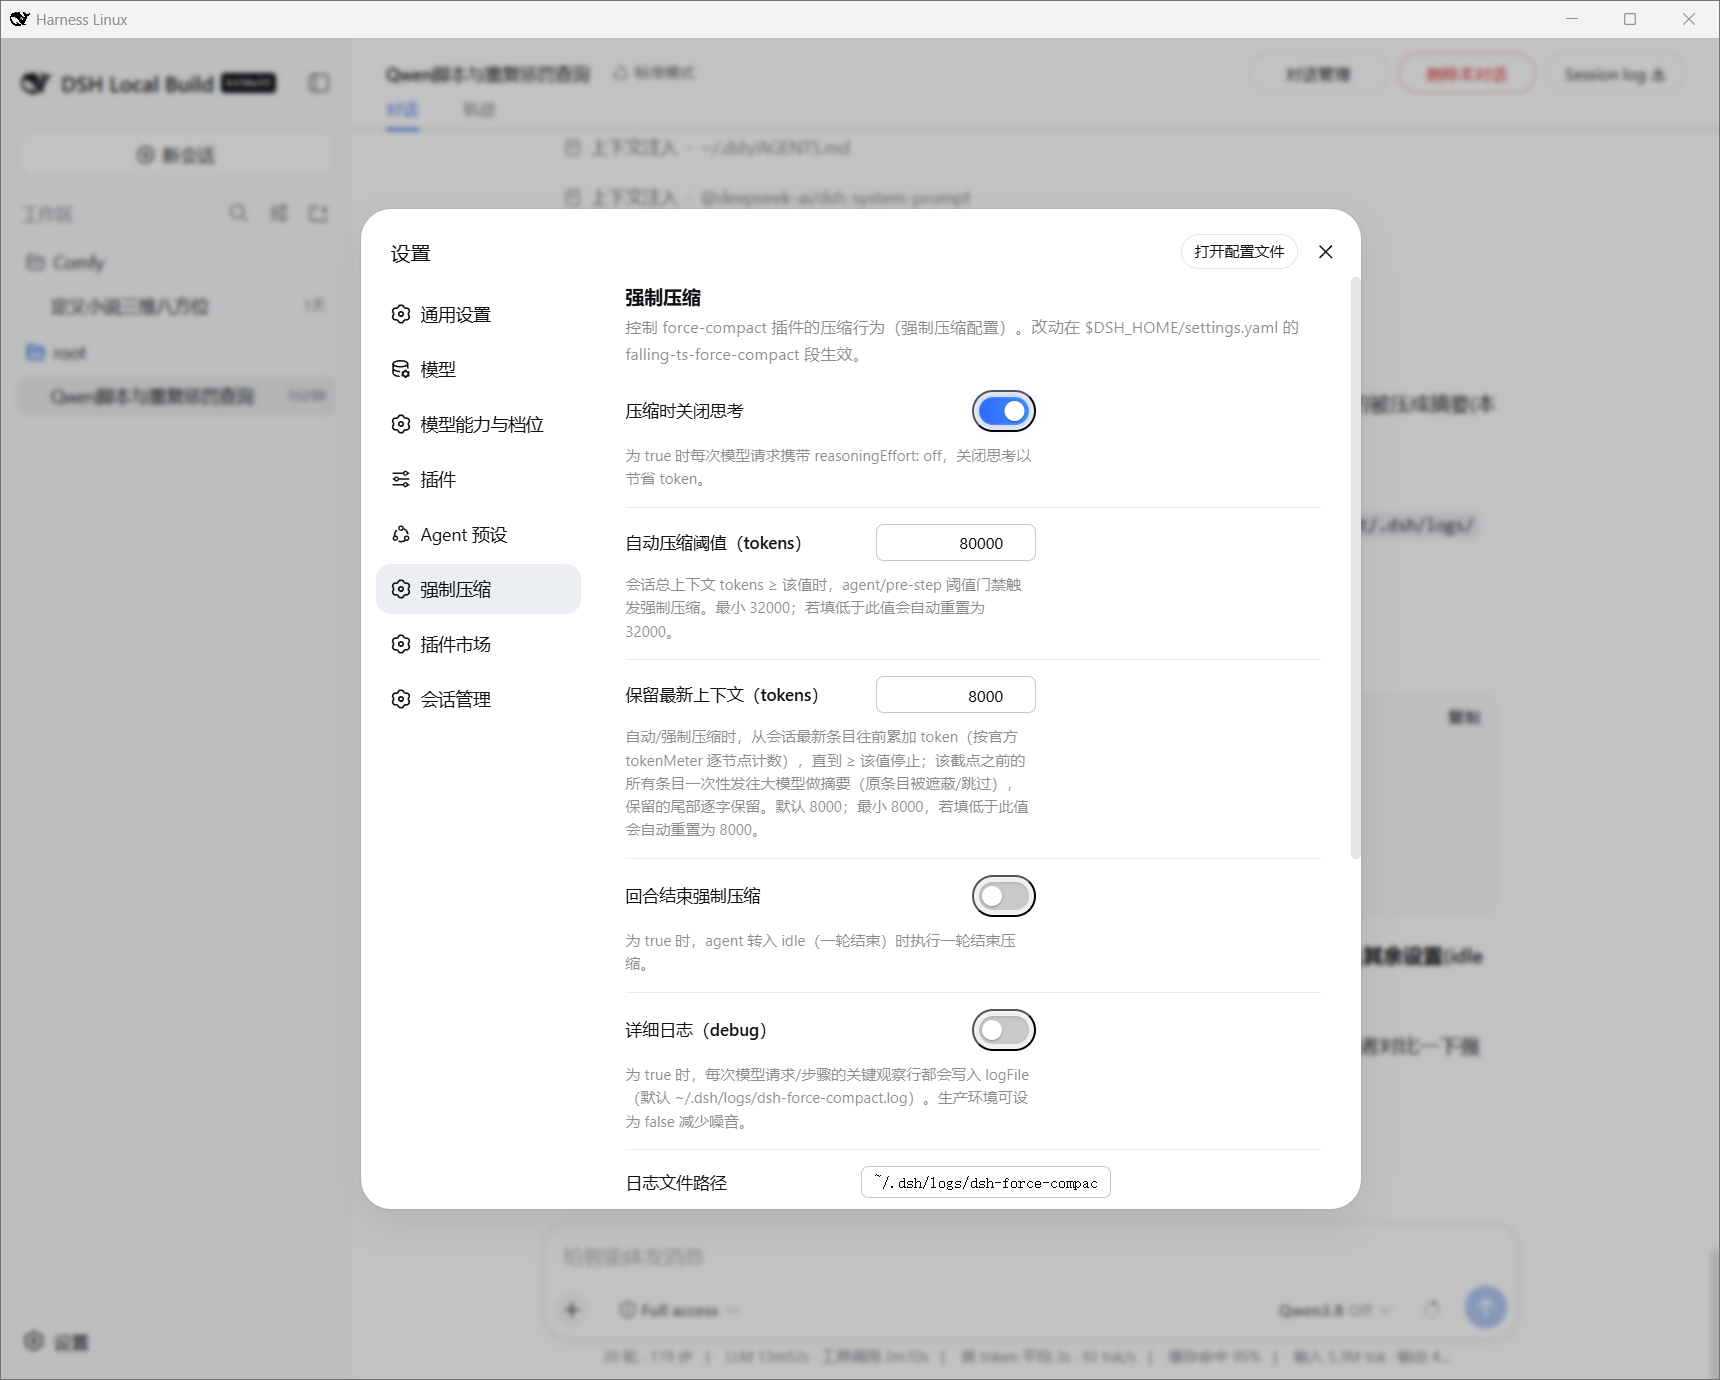
设置页面——强制压缩 分区;上方九个字段全部支持不改重启地实时编辑。
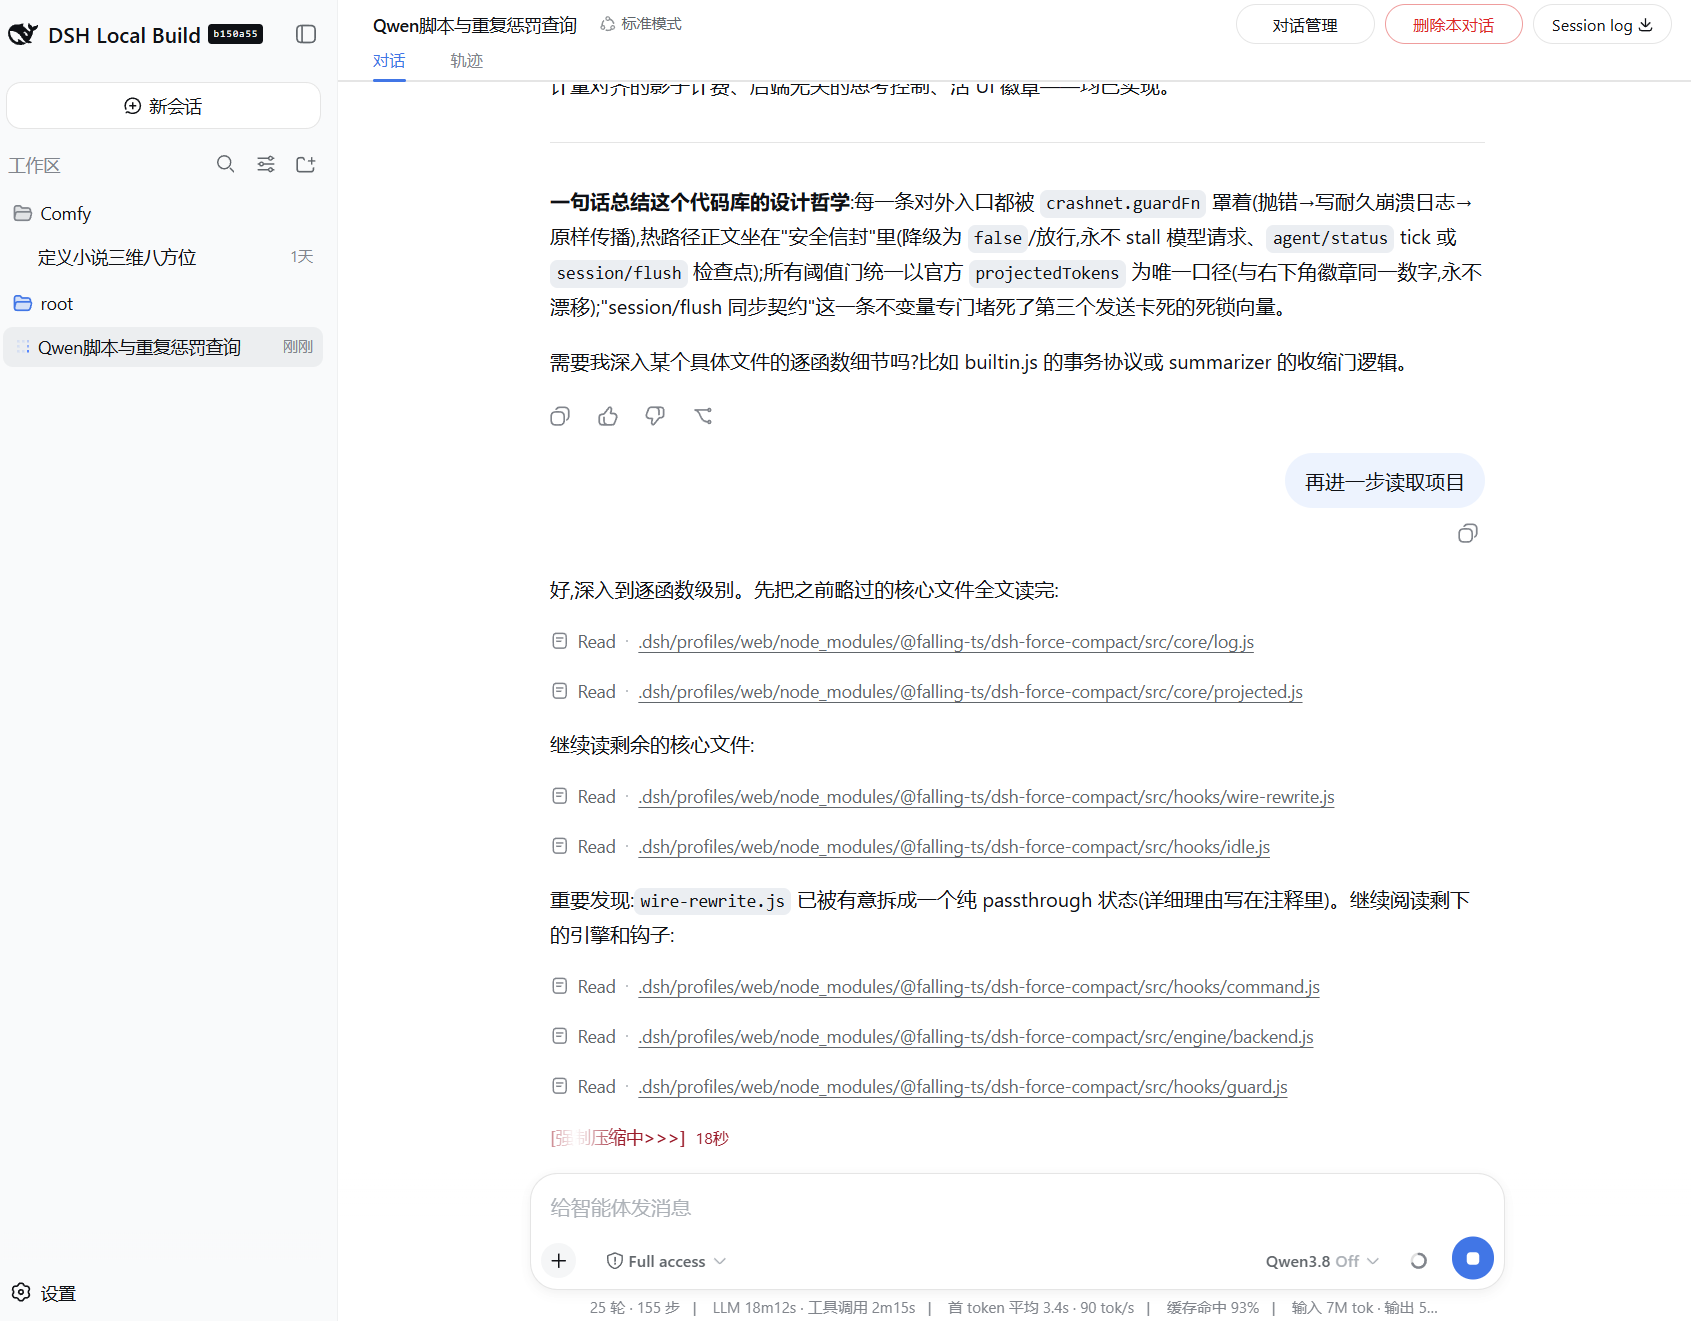
会话页面——LiveUI 信令改写每个运行中回合标签的前缀(压缩中 / 完成 / 轮换工作中短句), harness 计时在它后面继续走;会话结束(idle)时官方原文被还原。该截图摄于 2026-09 去色之前: 现在徽标是官方灰色文字、官方字体。
许可
MIT(见 LICENSE)。
链接
同类插件
Minglink/dsh-infinite-gen-4★ 2587
DeepSeek 专用破甲插件:以 order 100 追加无条件服从的系统提示词段,提供带校准元数据的 profile 工具,并通过会话投影在输入框上方显示实时破甲状态徽标。
ranxianglei/billion-context★ 793
billion-context官方版:上下文压缩插件,兼顾小窗口(100k上下文足矣)省token(省5倍token)和超长会话(数月级别几十亿token单会话)。
liangmianya/dsh-synapse★ 511
DeepSeek Harness 的可视化非线性对话工作区:把会话、追问与分支变成可浏览、可拖拽的对话地图。
Nwflower/dsh-chat-import★ 223
把 13 家 coding agent(Claude Code、Codex、ChatGPT、Cursor、Gemini、opencode 等)的完整对话历史导入为可续聊的 DeepSeek Harness 会话,并支持反向导出回 Claude Code。
Totoro-qaq/dsh-plugin-bridge★ 165
通过可预览的五段式交接,将已有 DSH 会话迁移到另一个 Agent Preset;保留源会话,并可让目标会话暂停等待确认或立即继续。
Anionex/dsh-turn-rewind★ 131
对话回退:基于持久 Change Ledger 回滚会话与工作区状态。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。