为内置 web_fetch 工具提供 Playwright/CDP 后端:用真实浏览器渲染网页,经 Readability + DOMPurify 降噪后返回 Markdown。
安装
# npm 包(预构建)
dsh plugin --profile web add dsh-web-fetch-playwright
# GitHub 源码(首次需按提示配置 allowBuilds 构建授权后重试)
dsh plugin --profile web add github:chendefine/dsh-web-fetch-playwright
装任何插件都等于在你的机器上跑第三方代码,权限和你本人一样大——能读你的文件、用你的凭据、访问网络,工具审批管不到它。GitHub 来源的插件还会在安装时执行构建脚本——pnpm 默认拦截,所以安装可能停在 ERR_PNPM_GIT_DEP_PREPARE_NOT_ALLOWED 或 ERR_PNPM_IGNORED_BUILDS;dsh 会打印出需要添加的确切键名,把它加进该 profile 的 pnpm-workspace.yaml 的 allowBuilds 下,重跑一次即可装上。放行构建本身就是一次信任判断:请只安装可信来源,并尽量锁定 commit(github:owner/repo#sha)。
README
DeepSeek Harness(DSH)双端插件:为内置 web_fetch 工具提供 Playwright/CDP 后端——用真实浏览器渲染网页,经 Readability + DOMPurify + Turndown + GFM 降噪(清洗导航栏、侧边栏、页脚、贴片广告)后输出 Markdown。
特性
- 真实浏览器渲染 —— 以用户视角加载页面,SPA 客户端渲染内容也能抓到,而非只有原始 HTML。
- 降噪管线 —— Mozilla Readability 提取正文,DOMPurify 移除布局/噪音标签(导航、侧边栏、页脚、广告、表单),Turndown + GFM 插件按与内置
tool-web渲染器一致的风格转成 Markdown。内联data:图片(Docusaurus 等构建工具会把截图以 base64 内嵌进 HTML)会被替换为带大小的占位符,如,避免 base64 字符流刷屏。对列表型页面(门户首页、商品目录——正文本身就是链接),Readability 的链接密度打分会误选出噪声碎片(实测 163.com 首页:96 字符的页脚备案块胜出,320 条新闻标题得分趋零),因此抽取结果需通过覆盖率置信门——不足 250 字符、或占页面可见文本不足 10% 即不予采信,转而回退到整页消毒转换,此类页面上可基本完整保留列表内容。通过置信门的抽取结果再做尾部链接密集块修剪——正文之后的推荐流、分享栏往往随正文一起被裹进胜出的容器里,且能躲过所有基于类名的规则(163 的post_recommend卡片单卡链接密度 0.42–0.48,恰好低于 Readability 自己 0.5 的删除线,且抽取后类名尽失、无从匹配);只有当尾部连续块**既占容器文本少数、又明显比其前的正文更"链接化"**时才整体移除,因此链接列表型抽取(信息流、门户头条)不受影响。 - PDF 链接 —— 当 URL 返回的是 PDF(inline 的
application/pdf、Content-Disposition: attachment下载,或文件头为%PDF-的application/octet-stream)时,按字节读取并转换为 Markdown,而不是报错:pdf.js(通过unpdf)提供带坐标的文本和真实字体名,版面启发式规则据此还原标题(书签、3.1/第二章/一、等章节编号、字号、独立粗体行)、段落(间距、首行缩进、跨栏跨页衔接、基于全文词表的断词合并、中日韩文字无空格拼接)、列表、等宽代码块、列对齐的 GFM 表格、行内粗体和<!-- page N -->页码标记,同时去除页眉页脚和页码。详见 PDF 链接。 - 两种后端 —— 本地启动 Playwright 浏览器,或通过 DevTools 协议(CDP)驱动一个已在运行的浏览器。
- 浏览器解析 —— 配置路径 →
$PATH上的playwrightCLI → 插件自带的playwright-core;CDP 模式完全不需要本地浏览器。 - 共享 profile 或复用隔离上下文(CDP) —— 每次抓取通过共享 CDP 连接创建自己的标签页,用完即关。默认复用浏览器已有默认 context 与登录态(
connectOverCDP→browser.contexts()[0],类似关闭隔离后的 CLI CDP attach,而不是playwright-cli open)。会话隔离按需创建独立的内存 context,仅在同一会话的抓取或其他标签页仍在使用时复用;全局隔离则在同一插件实例内跨会话保留并复用一个固定的隔离 context。本地后端仍每次抓取启动并关闭浏览器。 - 热配置 —— 插件页(侧边栏 → 插件 → dsh-web-fetch-playwright,dsh ≥ 0.1.7)在插件自己的包页面直接展示完整表单(也可通过该行的「配置」入口进入同一表单);可随时切换后端、上下文模式、降噪开关与并发数,提交的改动对下一次抓取即时生效,无需重启。
- 预算控制 —— 单次抓取 25s 等待预算——预算耗尽时(加载过慢、无限下拉的信息流)不再继续等待,而是直接对页面已渲染的内容做提取并返回,而不是报错(文档未加载完成时标记
truncated;只有完全没收到响应、或提取本身超出 10s 宽限时才报WEB_FETCH_TIMEOUT);并发按后端定价(maxConcurrency,默认本地 4 个浏览器 / CDP 50 个标签页;排队的抓取等不到空位会在 10s 内尽快报错并提示重试,而不是一直挂到被工具层中止);拦截图片/字体/媒体子请求;返回体 10 万字符封顶。 - Cloudflare 挑战有界等待 —— 导航落到验证中间页("Just a moment…" 及其多语言同族,通过官方
cf-mitigated: challenge响应头 + 结构性页面标记识别)时,抓取保持同一标签页与上下文,等待浏览器自行通过验证:跟踪最后一次主 frame 响应(真实页面随后重载进来),并轮询活 DOM 以捕获 SPA 式清除。有界(内置 15s 上限),附带同标签页有界重试(challengeRetries,默认 1)。窗口耗尽时,先经由页面自身的纯 HTTP 请求通道对同一 URL 做一次再拉取(challengeHttpFallback,默认开启)——同一个 cookie 罐、浏览器自身的 UA,但没有 Chromium 的渲染决策——因为很多 Cloudflare 边缘会对这样的请求直接下发真实文档,却对浏览器会话扣住交互式挑战不放;回取的响应必须本身不是挑战页,否则仍按失败处理。仍失败时,才以独立的WEB_FETCH_CHALLENGE错误码明确失败,而不是把中间页当正文返回。全程不点击、不注入验证码答案、不伪造浏览器状态、不导出或复制 cookie。 - 视口虚拟化信息流与应用壳文档的深度抓取 —— 论坛帖子、评论区、时间线类页面越来越多只渲染滚动位置附近的内容(Discourse 帖子流把视口外的每一楼都替换成只保留楼层 id、不含任何正文的高度占位符),应用壳文档编辑器(飞书文档一族)更进一步:body 根本不滚动、块以
data-block-id标识而没有 id、窗口外的块被直接移除、只留匿名高度占位符。静止快照只会拿到骨架或首屏而正文静默丢失。抓取因此在序列化前执行一次有界的页内滚动遍历:文档可滚时走窗口,否则走页面主导的内层滚动容器;暂存每个渲染窗口的内容(每个 id/data-block-id保留最丰满的快照),逐步走到底部——只有"触底且高度停止增长"才意味着分页加载完毕——然后在页面的结构化克隆里用暂存快照再水合所有退化的键元素、把被移除的键插回其存活兄弟旁边,并把完全没有 DOM 身份的行(react-window 列表、X 式时间线)从引擎移除它们的那一刻起还原回来,并由遍历自行序列化该克隆(活文档从不被改写)。对滚动毫无反应的页面(绝大多数网页)会被识别出来并跳过慢速遍历。受内置 20s 预算约束;任何失败都静默降级为旧版抓取。
工作原理
| 半端 | 位置 | 职责 |
|---|---|---|
| 宿主(服务端) | src/ |
向 ctx.web 注册 fetch provider(id playwright);cordis.patch.yml 把 web seam 的 fetchProvider 固定为本插件,并启用 web_fetch 工具(60s 预算)。 |
| 浏览器(客户端) | src/client/ |
在插件页的 plugins.bundle.config / plugins.row.config 席位注册 Playwright 网页爬取 配置表单,通过共享的设置表单服务提交改动。 |
web_fetch (tool-web)
   └─ ctx.web.fetchProvider = playwright
        ├─ local: 解析(路径 → $PATH → 内置 playwright-core)→ chromium.launch
        ├─ cdp:   connectOverCDP(endpoint)
        ├─ PDF(inline / attachment / 嗅探出的 octet-stream)→ 字节(导航响应体,否则 request context 重新拉取)→ pdf.js → 版面启发式 → Markdown
        ├─ page.goto → 等待稳定(load 基线 + 有界网络静默窗,陈旧在途请求不再阻塞——尽力而为;不再用 Playwright 的 networkidle:worker 脚本与跨域认证请求在页面会话上永不完成,严格空闲在现代 SPA 页面上不可达)→ 深度抓取滚动遍历(虚拟化信息流;有还原时直接返回其合并且已剥离的结果)→ 否则在活 DOM 中剥离脚本子树 → page.content()
        ├─ 降噪:jsdom → 内联 data: 图片改占位符 → Readability → 覆盖率置信门 → 尾部链接密集块修剪 → DOMPurify → Turndown(GFM)
        └─ Markdown(关闭降噪时返回原始 HTML)
非 2xx 状态码是结果而非错误 —— 这是 web seam 的契约(@deepseek-ai/dsh-web):抓取到的 404/418/500 会连同状态码一起正常返回,与 dsh-web-fetch-http 的行为一致。但对仅有状态的响应 Chromium 会把事情搞砸 —— 空 body 的错误状态(httpbin 的 /status/404)会让整个导航以 net::ERR_HTTP_RESPONSE_CODE_FAILURE 失败,204/205 则因无可渲染内容被中止(net::ERR_ABORTED)。因此 provider 在每次抓取中都跟踪最后一个主框架响应(该响应先于 Chromium 判定导航失败到达),并把这类失败恢复成带状态码的正常结果,web_fetch 会报告 Fetched … (HTTP 404) 而不是抛出 WEB_PROVIDER_ERROR。同样的恢复也覆盖下载型响应 —— 带 Content-Disposition: attachment 的 body(publish.twitter.com 的 oembed 端点——agent 读取推文常用的替代 URL——返回的 JSON 正是如此)永远不会被提交为文档:goto 以 Download is starting 拒绝,且 body 已从网络栈中流失,provider 因此通过页面的 API request context 重新拉取并返回可解码内容;PDF 下载会被提取为 Markdown(见 PDF 链接),其他不可解码的下载(ZIP)仍以 WEB_UNSUPPORTED_CONTENT_TYPE 失败。若恢复出的响应本身来自 Cloudflare 挑战边缘,仍以 WEB_FETCH_CHALLENGE 失败;持续性传输错误与取消依旧按错误处理——但瞬时传输抖动会先重试:net::ERR_NETWORK_CHANGED(Chromium 的 NetworkChangeNotifier 因宿主机网络配置在导航途中变化——路由/DNS/VPN/Docker 内嵌 DNS 改写——而掐灭了在途请求;实测:某会话抓取 source.android.com 一次即如此失败,同一 URL 数秒后从同一宿主机干净抓回)及其同族错误码(ERR_CONNECTION_RESET、ERR_NAME_NOT_RESOLVED 等)会在同一页面上带短退避地重导航至多两次,且受剩余抓取预算约束;ERR_ABORTED 与 Playwright 超时错误从不重试(它们的形态是确定性的,已由上述各恢复逻辑分别接管)。
Web Component 应用外壳跳过它注定赢不了的 Readability 家族,大页面也不再反复重解析同一份 DOM。 降噪管线是同步的且以 jsdom 为主,重页面会在浏览器已拿到完整文档之后把全部开销变成"死等"——实测坏例(aistudio.google.com/docs/computer-use,经 CDP 抓取进用户的真实浏览器):页面 ~7 秒渲染完整,之后管线又在 1.1MB 的捕获上花掉 13.4 秒,其中 ~6.5 秒是三次 Readability、~2.9 秒是八次 DOMPurify 重解析。而这些开销里有相当一部分产出的是可证明的死候选:该页是 Angular 应用,整个 DOM 都在 <ms-app> 之下,而 DOMPurify 的白名单不含带连字符的自定义元素标签,配合 KEEP_CONTENT: false,凡携带该包装的提取物净化后只剩空壳(Readability 的选中项:词数为零的根;整文档候选:约 4.5k 词只剩 39 个)。因此当 body 可见文本有 ≥90% 位于自定义元素子树内时(customWrappedTextShare),候选生成直接跳过 Readability 家族(art/artu/artx)并在 facts 中标记(readabilitySkipped);选择器会被注入死选中项本应测得的空 art 参考统计,存活候选的特征因此不变,由 DOM 兜底候选、noscript 路径和块分类器——选择器在这种页面上本来就会选中的那些——承担提取(标题回退到 og:title/<title>)。另外,生成器本来就持有 DOM 节点的候选(doc、docc、main、ns_doc)改为按节点净化(输出逐字节一致,整文档候选实测 555ms → 304ms),不再重解析其序列化文本;Readability 文章对覆盖门限与尾部修剪只解析一次;推荐位名称识别先用字面子串短路再做逐 token 切分(坏例页上省 ~360ms)。坏例页的净效果:管线 13.4s → 5.0s,端到端 21–23s → 13–15s,胜出策略与内容不变;在 63 页的基准输出对比样本上(门控一页都未触发)输出逐字节一致,仅坏例页本身多保留了一行标签文本。
回读文档前,先在活 DOM 中剥离非内容脚本子树 —— 构造上即输出中性。 降噪管线(以及关闭降噪时工具层自己的渲染器)会用 jsdom 重新解析 page.content(),而脚本的文本内容是这条往返链路中唯一无法信任的东西:页面自身的运行时 JS 可能把内嵌 </script> 的文本写回某个数据脚本的 textContent —— 实测于 techcommunity.microsoft.com(Khoros/Aurora 平台),其客户端把整个 Apollo 缓存经 JSON.stringify 写回 script#__NEXT_DATA__,把线上响应里 712 处 \u003c 转义还原成了裸 < —— 而浏览器序列化脚本文本时原样输出,于是这份扁平化的 HTML 字符串会在第一个内嵌结束标签处终止脚本,把余下约 270KB 的 JSON 当作标记语言解析。解析出的幽灵元素(<id> 之类的未知标签、塞满 CSS 与 i18n 字符串的锚点)恰好是 Readability 评分器眼里的"正文质量"(实测 126 分对真实正文的 45 分),于是抓取 RDP 10 AVC/H.264 一文时返回的是 CSS 规则和 CachedAsset 字符串而不是文章本体。事后再对字符串做补丁无法消除这种歧义 —— 只有浏览器自己的解析持有文档的真实结构 —— 因此普通的 script 与 template 子树在 page.content() 之前先在活页面里剥掉(page.evaluate,尽力而为)。这不会改变管线以往的任何输出:Readability 本就在抽取与评分前删除 script/noscript 节点,DOMPurify 的白名单本就丢弃 script,工具层渲染器也整体移除 SCRIPT/TEMPLATE —— 在真实页面语料(Wikipedia、MDN、Hacker News、坏例页 wire 版,加上 noscript/JSON-LD/template 边界用例)上的差分 A/B 每一页都字节级一致。两个刻意的保留让间接消费方也不受损:script[type="application/ld+json"] 只做消险而非删除(</ 改写为 <\/ —— 仍是合法 JSON,Readability 的元数据读取解析到同一对象,文章标题保持无站点后缀的干净形态,如 "Remote Desktop Protocol" 而非 "… - Wikipedia");noscript 完整保留,因为 Readability 的 _unwrapNoscriptImages 会从懒加载的 <noscript><img …> 包裹中抢救出真实图片。该剥离在关闭降噪时同样生效,让返回给工具层渲染器的原始 HTML 也是序列化安全的,并把管线要解析的体积压缩约 70%(以该坏例页计)。
环境要求
- DSH web profile(
dsh web),Node.js ≥ 20。 - 本地后端:装有 Chromium 的 Playwright、Chromium 系浏览器可执行文件,或默认缓存里有浏览器的
playwright-core。 - CDP 后端:任意已带
--remote-debugging-port启动的浏览器(如chromium --headless --remote-debugging-port=9222)。
安装
从 npm registry 安装(预构建产物,无需构建授权):
dsh plugin --profile web add dsh-web-fetch-playwright
从 GitHub 仓库安装(源码型,pnpm 会在安装时跑 prepare 构建;若 pnpm 拦截构建脚本,请在 profiles/web/pnpm-workspace.yaml 中放行该包):
dsh plugin --profile web add github:chendefine/dsh-web-fetch-playwright
或通过 DSH 插件市场(设置 → DSH插件市场)一键安装——本仓库带 dsh-plugin topic,会被自动收录。
bundle 插件加入 profile 层栈后需重启 dsh web 生效;卸载用 dsh plugin --profile web remove dsh-web-fetch-playwright 后重启。
配置项
插件页(侧边栏 → 插件)从列表一跳即达:dsh-web-fetch-playwright 卡片落在包页面,完整表单位于其描述与行列表之间;该行的「配置」入口在插件自己的标题下打开同一表单。表单实时编辑 web-fetch-playwright 设置段(由插件条目的 Config schema 派生):
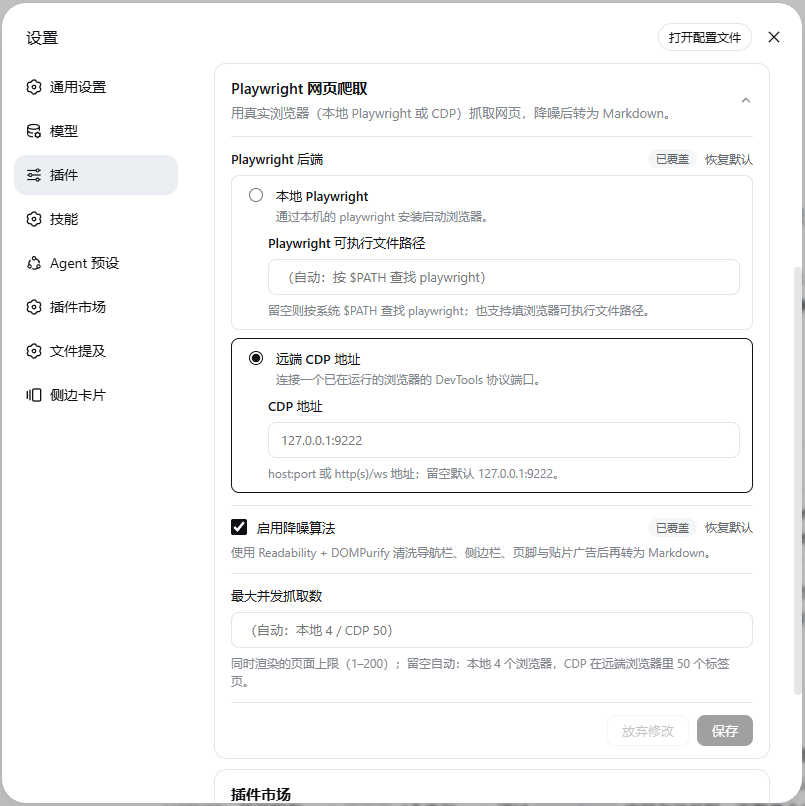
| 字段 | 默认 | 说明 |
|---|---|---|
backend |
local |
radio:本地 Playwright / 远端 CDP 地址,每个选项内嵌各自的填空。 |
playwrightPath |
空 | 本地后端:playwright 可执行文件或 Chromium 系浏览器二进制路径;留空按 $PATH 查找,再回退到内置 playwright-core。 |
cdpEndpoint |
127.0.0.1:9222 |
远端后端:host:port、http(s)://… 或 ws(s)://…。 |
shareBrowserContext |
true |
仅 CDP:单选共享 / 隔离。true 复用远端默认 context 与登录态;false 使用独立 context,生命周期由下方范围决定。本地后端忽略。 |
contextIsolationScope |
global |
仅 CDP 隔离模式:session 按 DSH 会话按需创建 context,无活动/待处理抓取且无打开的标签页后关闭(下次抓取使用全新状态);global 在同一插件实例内跨DSH会话复用一个固定的隔离上下文。 |
denoise |
true |
是否启用降噪;关闭时返回整页渲染 HTML,交由工具层转换。 |
maxConcurrency |
(自动) | 同时渲染的页面上限(1–200)。留空按后端取默认:本地 4(每个槽位启动一个浏览器)/ CDP 50(远端浏览器已就位,每个槽位只是一个标签页)。超出的请求短暂排队;10s 内等不到空位则以 WEB_FETCH_TIMEOUT 尽快失败并提示重试或调大该值,而不是一直挂起直到工具层预算中止。 |
challengeRetries |
1 |
一个等待窗口耗尽后的同标签页重新导航次数(0–3);浏览器已拿到的通关 cookie 留在上下文里供重试使用。总耗时始终受 25s 单次抓取等待预算约束。 |
challengeHttpFallback |
true |
浏览器在窗口内清不掉挑战时,经页面自身的纯 HTTP 请求通道对同一 URL 再拉取一次(同 cookie、浏览器 UA、无渲染决策),回取到非挑战文档则直接返回。false 保持纯浏览器姿态。 |
本地后端解析顺序:
- 配置的路径(自动判别 Playwright CLI / 浏览器二进制);
$PATH上的playwright(其包自带该安装的浏览器注册表);- 插件内置的
playwright-core——需要PLAYWRIGHT_BROWSERS_PATH或默认缓存里有浏览器,否则报错会提示playwright install chromium。
Windows 说明 ——
$PATH已按平台分隔符(;)扫描,但 npm/pnpm 全局安装暴露的playwright是.cmd/.ps1垫片,从垫片位置向上找不到包根,自动发现可能仍落在第 3 步(内置 core)。要使用指定安装的浏览器注册表,请把playwrightPath显式指向playwright包目录或浏览器二进制。
CDP 模式不需要本地浏览器:插件在生命周期内对远端浏览器保持一条共享连接(连接断开自动重连,地址改动后自动换连),每次抓取只租用远端浏览器里的一个标签页,抓取结束即关闭。因此并发数按"标签页"计,默认也更高(50)。插件卸载时断开共享连接(绝不会关闭远端浏览器本身)。
CDP 上下文模式(是否共享浏览器 profile)
选择共享浏览器上下文(默认)时,在远端浏览器已有的默认 context 内开标签页,双向共享 cookie / localStorage 并复用登录态;插件永不关闭这个默认 context。资源过滤与弹窗守卫只作用于本次抓取自己的标签页。
选择隔离浏览器上下文后,再选择复用范围:
- 按 DSH 会话隔离:按 DSH 会话 ID 按需创建独立 CDP 连接、独立 context 和专属浏览器窗口。即便 CDP 网关把每条连接的第一个 context 映射为独立 Chromium,不同会话也不会落入同一连接下的嵌套 context;空闲回收时连同该会话的连接一起释放。同一会话的并发抓取在自己的 context/窗口内各开一个标签页,每次只关闭自己的标签页。创建 context、创建标签页,以及“关标签页→检查是否为空→关 context”都在同一把按会话键划分的 FIFO 锁内执行;网页抓取仍可并发,不同会话互不阻塞。没有抓取标签页或其他打开的标签页后关闭 context;排队的新建请求须等待关闭完成,再创建新的 context。回收后 cookie / localStorage 重置。实现校验真实 CDP context ID 和 window ID,按 target ID 匹配新页面;端点不支持这些隔离保证或调用缺少会话 ID 时明确失败,绝不回退到默认 profile。
- 跨DSH会话全局复用(默认):本插件实例内所有 DSH 会话复用一个固定的隔离 context。
插件自行创建隔离 context,不查找其他工具创建的 context。全局隔离仍在抓取之间保留 context:抓取结束仅关自己的标签页,因此后续抓取可沿用 cookie / localStorage。会话隔离则按上述规则,在没有活动/待处理抓取且没有打开的标签页后释放 context。这是内存复用,不保证浏览器或插件重启后保留;上下文配置变更会退役旧 context,卸载、断连或连接替换也会清理。全局隔离仅与浏览器 profile 隔离,不隔离同一插件实例内的其他 DSH 会话。
如果其他 CDP 客户端删除了插件拥有的隔离 context,Chromium 不一定触发 Playwright 的 context close 事件。遇到明确的 Target.createTarget “Failed to find browser context with id …” 错误时,插件只让对应缓存失效,并在新的 context 中最多重试一次开标签页。并发请求复用同一个替代 context;被删除 context 的 cookie / localStorage 不会恢复。其他 context 与默认 profile 不受影响。该恢复机制不会重试普通页面错误、重放网页导航或回退到默认 profile。
profile 模式风险须知 —— 它把 web_fetch 从"匿名读网页"升级为"以浏览器登录身份行动":
- 被抓取的恶意页面若诱导 agent 请求 GET 型状态变更 URL(登出、改设置、API 操作),请求会自动携带会话 cookie。
- 同一站点的并发抓取共享一个 cookie jar,一方的登出 /
Set-Cookie会影响另一方。 - 输出开始依赖浏览器历史(A/B 分桶、语言偏好);远端 profile 的站点数据只增不减,插件不做清理。
登录态持久的前提是 user-data-dir 持久化。有头(推荐,手动登录一次):
google-chrome --remote-debugging-port=9222 --user-data-dir="$HOME/.config/chrome-dsh-profile"
无头服务器(先在有头环境预置登录态):chromium --headless=new --remote-debugging-port=9222 --user-data-dir=/data/chrome-dsh-profile。不要叠加 --incognito 或一次性 user-data-dir——都会让 profile 模式失效。设计依据与已核实的 playwright-core 源码事实见 docs/context-mode-profile.md。
Cloudflare 挑战处理(有界自然等待)
部分严格站点会在返回真实页面前先给一个 Cloudflare 验证中间页。真实浏览器通常几秒内就能自行通过验证;但只看第一次响应的抓取会把中间页当成正文返回(0.2.5 之前的旧行为;可在仓库检出、执行 pnpm build 后运行 node scripts/challenge-demo.mjs 看本地模拟站点的前后对比、node scripts/challenge-online.mjs <url> 对真实站点做在线对比)。
开启等待(默认)后的流程:
- 识别 —— 响应带
cf-mitigated: challenge(Cloudflare 官方文档注明所有挑战页类型都带此头),或 403/503 且server: cloudflare的 HTML 文档,或本地化的中间页本身("Just a moment…" / "请稍候…" / "Минутку…" 等 title 家族,以及结构性标记:挑战运行时的<script src>、#challenge-*元素、cf-chl-widget-框架、window._cf_chl_opt)。内容级标记只是兜底层,且仅对"挑战兼容"的响应(403/429/503 或来自 Cloudflare 边缘——server: cloudflare/cf-ray)运行——因为中间页从不会以普通 200 返回,所以正文里引用了挑战文案的普通文章绝不可能被误判。两处收紧让这个承诺真正成立:挑战平台脚本只读真实的<script src>属性(正文、以及转义后的代码示例里引用的路径一律忽略),并且正面匹配运行时挂载点/cdn-cgi/challenge-platform/h/[b|g]/orchestrate/。该前缀下 Cloudflare 注入的其余脚本——Bot Management 的 JavaScript Detections(scripts/jsd/、h/[b|g]/scripts/jsd/<hash>/、h/[b|g]/jsd/r/)与 Precursor(scripts/precursor/)——都是会注入受保护站点每一个正常页面的被动探测脚本(如 openrouter.ai、nodeseek.com),永远不算挑战信号。硬封锁页("Sorry, you have been blocked")单独分类并立即失败——等待无法解除。 - 同标签页、同上下文的有界等待 —— 每 500ms 轮询活 DOM,等浏览器跑完自己的验证;同时跟踪最后一次主 frame 导航响应,所以重载进来的真实文档的状态码和响应头才是最终上报的。SPA 式清除(无导航、纯内容替换)由同一个 DOM 探测捕获。
- 有界重试 —— 窗口耗尽后,同一标签页默认再导航一次(
challengeRetries),上下文里已有的通关 cookie 继续生效。 - 死局回取 —— 失败之前,先经页面自身的请求通道对同一 URL 做一次纯 HTTP 再拉取(
challengeHttpFallback,默认开启):同一个 cookie 罐、浏览器自身的 User-Agent,没有 Chromium 的渲染决策。很多 Cloudflare 边缘对这样的请求直接下发真实文档,却对浏览器会话扣住交互式挑战(实测:数据中心 IP 访问 v2ex.com——浏览器 15s×2 只拿到空的 widget 帧,纯 HTTP 请求拿到完整正文)。回取的响应必须本身不是挑战 HTML——响应级与内容级双重校验,与浏览器路径同一条分类链——否则保持浏览器-only 的判定。 - 明确失败 —— 返回独立的
WEB_FETCH_CHALLENGE错误码(web seam 的code是开放字符串,允许 provider 专属码),消息中写明站点、等待预算与最后一次挑战响应的状态。
安全边界(刻意为之):不点击 Turnstile、不解验证码、不注入 token、不伪装指纹/UA、不轮换代理、不导出 cookie——CDP 隔离模式下通关态保留在对应会话 / 全局 context 中,直到该 context 被清理(本地 context 仍随每次抓取结束);profile 模式下它留在远端浏览器自己的 profile 里,插件从不复制或清理。等待始终受内置 15s 上限与 25s 单次抓取等待预算双重约束,永不无限阻塞。
深度抓取(视口虚拟化信息流与应用壳文档)
信息流形态的页面——Discourse 帖子流(linux.do、meta.discourse.org)、评论区、时间线——只渲染滚动位置附近的条目。静止时活 DOM 里只有一个窗口的真实内容,窗口外的每个条目都是只保留身份、不含内容的高度占位符:
<div class="post-stream--cloaked" data-post-number="1" id="post_1" style="height:297.9px !important;…">
  <h2 class="sr-only">由 Diver-QC 于 2 小时前 发布</h2>
</div>
渲染后从不滚动、只序列化某一瞬间的抓取,交回的就是骨架——屏幕阅读器专用的"由 X 发布"标题穿过管线存活下来、看起来像正文,真正的楼层正文全部消失;连降噪管线的覆盖率门控也发现不了(页面自身的可见文本和提取结果是同一份被窗口化的残片)。只滚动到底部一次同样不行:渲染窗口是移动的——在一个 40 楼的 linux.do 帖子上实测,静止 DOM 只有前 ~6 楼,一步跳到底只剩最后 10 楼,而且第一块之后的楼层根本不在 DOM 里,要等触底 sentinel 拉取。
应用壳文档编辑器把同样的病理又下沉了一层——实测坏例是飞书 wiki 页面(bocha-ai.feishu.cn/wiki/…):body 根本不滚动,html/body 被锁死在恰好一屏,文档在 div.bear-web-x-container 里滚(实测:documentElement.scrollHeight 720 == innerHeight,window.scrollTo(0, 800) 后 scrollY 仍为 0,而容器以 656px 的 client 撑着 4534px)。它的块虚拟化比 Discourse 多两个变化:块以 data-block-id 标识、没有 id;窗口外的块被直接移除——整段未渲染尾部只是一个匿名的 .bear-virtual-renderUnit-placeholder 显式高度占位符——于是既没有窗口滚动条可走、没有 id 可暂存、也没有原地退化的行可换回,抓取只会返回静态渲染的首屏(实测:7 个块、892 字;完整文档约 190 块)。
修复是一次有界的页内滚动遍历(src/autoscroll.ts),在每个 HTML 文档的 settle 之后、序列化剥除之前执行:
- 解析遍历目标:文档自身可滚时走窗口(Discourse 形态);否则找页面的主导内层滚动容器(应用壳形态)——在 computed
overflow-y: auto|scroll的元素里取可滚距离最大者,且门槛为半个视口,下拉框级别的小滚动容器永远不会触发遍历。两者皆无则不遍历。 - 暂存每个键元素——以元素 id 为键,无 id 则用
data-block-id(加命名空间前缀,两种属性永不冲突)——为脱离文档的克隆(框架生成的 id 不算键:Ember 的ember123、ReactuseId的:r1:、«r1»、_r_1_每次渲染都会变,这类元素走下文的无键路径),每个键保留最丰满的一次观测(先以占位符形态被看到的行,会在渲染形态出现时升级),并记录其最近的带键兄弟:即它在自己所属列表中的位置。单条体积上限约 64KB:虚拟化行只有几 KB,而几十 KB 的元素只可能是整个信息流的容器(linux.do 实测:六层嵌套包装加上data-preloaded和svg-sprites,一次收集就把 2MB 预算烧掉 1.9MB),这类键会被记住、此后不再序列化。 - 遍历:从顶部起每次下移 70% 目标视口高度,每步为 300ms 平滑动画(按时间插值;
scrollTop驱动内层容器与window.scrollTo驱动文档完全同效)加 300ms 静置供信息流引擎的防抖 uncloak 生效;直到能在底部持续 2.5s 耐心窗口而高度无增长(真实信息流的分块拉取是网络往返,任何增长都会重新计时),或步数/预算上限关闭遍历。一个MutationObserver观察遍历存在的全部理由——页面因滚动而增删元素。连续两个谨慎步都无反应时,页面被视为对滚动惰性,剩余部分用一次跳到底部来探测;跳跃后一旦出现任何反应(uncloak、重新 cloak、加载更多的追加),遍历回退到起跳位置并谨慎走完。正确性从不依赖热身阶段的判断,只有惰性页面的开销依赖它。同一个观察器还负责收割无键行:引擎移除一个没有键的元素时,记录里仍有完整的已脱离元素,以及它被移除时左右的兄弟节点,合并时就把它放回那里。全程不读布局,绝对定位和transform都不影响。每个列表里,每个行身份只暂存一次(每帧重渲染的引擎会把同一行移除成千上万次,之后的观测只作锚点用),并且使用独立的字符预算,不会挤占带键暂存。瞬时 UI 从不收割(role=status|alert|dialog|tooltip|progressbar|menu|…、aria-hidden、aria-busy、无文本元素)。从未产生反应、也没有发出 fetch/XHR 的页面,在底部只停留 900ms,而不是完整的 2.5s 耐心窗口。实测:约 30 屏的静态长文开销约 2.4s,而不是耗尽 20s 预算;不需要滚动的页面没有任何额外开销。 - 合并到结构化克隆(
document.cloneNode(true))中:没有序列化/重解析往返,运行时改写进脚本文本的字面</script>无法污染合并结果;克隆没有浏览上下文,不执行脚本、不升级自定义元素、不加载 frame。插回(仅容器遍历):来自滚动容器内、而克隆中已不存在的暂存键是被引擎移除的(飞书形态,占位符是匿名的),插回到其记录的兄弟旁边,迭代求解,使一段被移除的连续块能从任一存活端链式还原;随已插回父级一同回来的键直接跳过。定位是结构性的,与遍历看到各行的顺序无关——包括从文档中部起步的锚点打开。替换:每个比快照更空的键元素(子元素更少,或文本明显更少——即 Discourse 占位符)被替换为快照,但容器除外(其后代中有待替换元素的祖先),容器由这些后代拼装还原——容器自身的快照只是某一窗口的局部视图。还原(无键行,在替换之前进行):只有在遍历期间引擎既从某个列表移除过带文本的行、又向它添加过元素时,该列表才符合条件。单个 toast 或加载更多的追加不算,位于aria-live="assertive"、role=alert|status|timer|marquee或轮播区域内的也不算。列表里已不存在的被移除行,会放回它被移除时所在的兄弟旁边。如果锚点本身也被移除了,就顺着它自己的邻居继续找;同一行的重复观测,解析到该行暂存副本最终落下的位置。每一次观测都会尝试,所以锚点打开时的首屏行,可以由后来看到它与邻居相邻的那一轮来定位。被整体重渲染(innerHTML)的列表没有存活锚点,这些行按移除顺序放到第一个带文本的行之前:自上而下、止于底部的遍历只会丢失最终窗口上方的内容。与仍存在的行去重时,引擎设置了按列表的身份属性就用它(data-index、data-item-index、aria-rowindex、aria-posinset、data-key、data-id等,限定在本列表内,不同列表间的重复值不会冲突),否则用行文本。身份属性相同但明显更空的现存行视为占位符,会被替换。引擎放在原行位置上的无键占位(紧挨该行、文本很短且被该行包含)会被吸收。已还原的列表及其祖先在替换阶段一律视为容器,带键的包装元素不会被替换成只有一个窗口的快照。随后克隆经过与活文档读取相同的脚本剥除(src/strip.ts)并序列化,provider 读取该字符串而非活页面。页面有反应但什么都没能还原时(行没有文本、canvas 渲染),遍历会滚回页面打开时的位置,等页面静止后再交给活文档读取;否则 provider 读到的是遍历停在底部的最后一个窗口,而不是旧版抓取看到的首屏。对滚动惰性的页面保持原位,它的 DOM 怎样都一样。
遍历在两种降噪模式下都运行;受内置 20s 预算与剩余等待预算的双重约束——在预算处截停的遍历仍会合并并返回已暂存的内容,正文读取与解码在其后的 10s 提取宽限窗内完成。任何失败——页面没有 evaluate、求值被拒、引擎拒绝遍历——都静默降级为旧版抓取:遍历只会增加内容,不会让抓取失败。CDP profile 模式下遍历滚动的是远端浏览器里抓取自有的那个标签页,与渲染发生在同一处。
真实坏例实测:linux.do 帖子(51 楼、约 18kpx)在 20s 预算内一次遍历走完,每楼都被再水合、零占位符残留;飞书 wiki 页面在 20s 预算中用约 11.5s 走完内层容器(15 步、插回 38 个被移除的块、最终 DOM 191 块——静止抓取只有 7 块),深部尾文(两处 JSON 示例与完整段落)都进入 markdown。公开的 react-window 演示页(/list/fixed-row-height,1000 个无键行)上,遍历以前只返回最后一个窗口(第 129–142 行);无键还原后按顺序返回第 1–155 行,没有重复,在 20s 预算耗尽处停止。无键路径的剩余限制:只有图片或用 canvas 渲染的行无法还原(遍历改为回滚);原地复用行节点的引擎(改写池中节点的文本,而不是移除它)不会被收割。一项如实记录的残余限制:飞书表格块的单元格藏在第二层块内虚拟化后面,遍历不追——表头与行能还原,超大载荷单元格可能保持为空。
PDF 链接
当抓取的 URL 实际返回的是 PDF 时,provider 会提取其内容,而不是以 WEB_UNSUPPORTED_CONTENT_TYPE 失败:
| PDF 的返回方式 | 浏览器的行为 | 字节的获取方式 |
|---|---|---|
application/pdf(inline) |
无头 Chromium 会下载它;有界面或经 CDP 连接的 Chrome 会打开内置查看器 | 导航响应体本身是 PDF 时直接使用,否则通过页面的 API request context 重新拉取 |
Content-Disposition: attachment |
goto 以 Download is starting 拒绝 |
通过 API request context 重新拉取 |
application/octet-stream 等通用二进制类型、.pdf 路径或文件名 |
下载 | 重新拉取后,以 %PDF- 魔数判定 |
重新拉取使用同一个浏览器上下文,因此 Cookie 和登录态(CDP profile 模式)对需要登录的 PDF 同样生效。字节交给 pdf.js(unpdf 的 serverless 构建,按需动态加载,插件启动时不会加载)解析,再由版面分析(src/pdf.ts)把带坐标的文本还原成 Markdown:第一页最大字号的文字作为 # 标题(否则用 PDF 元数据中的标题);标题层级来自书签、章节编号(3.1 / 第二章 / 一、)、更大的字号或独立成行的粗体;去除页眉页脚和页码;重建段落,并跨栏、跨页衔接;项目符号、编号条目、等宽字体块和列对齐的行分别转为列表、代码块和 GFM 表格;每页开头带 <!-- page N --> 标记。
限制与错误码:超过 50MB 的 PDF 以 WEB_PDF_TOO_LARGE 失败(下载前先按 Content-Length 检查);读取到 500 页、累计 10 万字符或抓取截止时间时停止,结果标记为 truncated,并注明最后读取的页码。没有文本层的扫描件以 WEB_PDF_NO_TEXT 失败(不支持 OCR;自带 OCR 文本层的 PDF 可以正常提取),加密 PDF 以 WEB_PDF_ENCRYPTED 失败,pdf.js 无法解析的数据以 WEB_PDF_INVALID 失败。已知局限:没有稳定列间距的表格(以及图中的标注文字)会以普通文本输出;多栏版面依赖 PDF 内容流的顺序;用矢量图形(而非字形)绘制的项目符号不会被识别为列表标记。
开发
pnpm install
pnpm typecheck   # tsc --noEmit
pnpm test        # vitest run(无浏览器时浏览器集成用例自动跳过)
pnpm build       # tsc 声明 + tsdown(宿主 ESM + 客户端 module-registration bundle)
用真实 Chromium 执行外部删除 context 的回归测试(测试自行启动浏览器和本地站点,不连接配置中的用户浏览器):
PLAYWRIGHT_TEST_EXECUTABLE_PATH=/path/to/chromium pnpm exec vitest run tests/cdp-recovery.browser.spec.ts
未指定路径时使用 Playwright 默认浏览器;默认二进制不存在会明确报告跳过。显式路径错误或启动失败则使测试失败。
仓库结构:
src/
├── index.ts               # 宿主入口:注册 fetch provider(设置段由插件的 Config schema 派生)
├── config.ts              # schemastery schema、CDP 端点归一化
├── provider.ts            # WebFetchProvider:导航、超时、信号量、截断
├── markdown.ts            # 降噪管线(Readability + DOMPurify + Turndown/GFM)
├── playwright-resolve.ts  # 本地后端发现(路径 / $PATH / 内置 core)
├── types.ts               # Playwright 结构化类型(运行时模块动态发现)
└── client/                # 浏览器半端:设置卡片、表单模型、多语言
tests/                     # 单元 + provider + 浏览器集成(可自跳过)
开发与发布流程见 CONTRIBUTING.md,安全模型与漏洞报告见 SECURITY.md。
安全边界
与内置 HTTP provider 同立场:未实现 SSRF/私网防护——浏览器能访问的目标,本 provider 就能抓。CDP 地址由设置页配置,不做回环限制,请在可信环境暴露设置页。抓取仅在本地渲染,除目标页面自身外不会向任何地方发送数据——但 profile 模式下请求(以及恶意页面诱导 agent 触发的状态变更)会携带远端浏览器的登录会话,见上文风险须知。
许可证
MIT © 2026 chendefine
链接
同类插件
Tencent/BrowserSkill#dsh-plugin-browserskill★ 10621
BrowserSkill 的 DeepSeek Harness 浏览器自动化桥接插件,通过原生浏览器工具控制可见的 Chrome 和 Edge Agent Window,支持可访问性与 VOM 页面观察、截图、隔离的多会话控制和 Web UI 实时观察浮层。
DDDMUC/dsh-free-search★ 1538
DSH 免费搜索插件,共 42 个引擎:6 个免 key 引擎(DuckDuckGo、Bing、SearXNG、Degoog、AnySearch)、6 个 key 与免 key 双档引擎(Exa、Tavily、Keenable、Firecrawl、Parallel、You.com)、5 个 HTML 搜索页,以及从 Brave、百度到知乎、OpenAI、Claude 的各类需 key 供应商。支持失败分类回退与冷却、多 key 轮换、引擎白名单、可增删的回退链、中英语言池、Multi 并发合并、12 个 MCP 工具与独立 stdio server,设置页可按引擎填写 key。
omdsh-dev/dsh-browser#packages/browser/bridge-browser★ 1111
Chrome 侧边栏扩展,让 DSH 直接操控你的浏览器,无需视觉能力。
liustack/modsearch★ 1026
纯文本 agent 的联网搜索桥:搜索网页与 X,返回结构化 JSON 证据(search/fetch/引用)。
Fisfzy/dsh-ego-browser★ 559
用 35 个结构化工具从 DeepSeek Harness 驱动真实 Chrome/Chromium:导航、语义快照、点击、表单、JavaScript/CDP、截图、下载与标签页管理;右侧边栏实时镜像页面,并支持鼠标键盘直接接管。插件自带受管 CDP 运行时,跨调用保留登录状态,并可通过配套 Chrome 扩展从日常浏览器导入 cookie。
wqty123/dsh-browser★ 196
共享真实浏览器:用户可观看并随时接管的原生 Electron 窗口,agent 通过 CDP 驱动,内置 20 个 browser_* 工具(打开/快照/执行/填表/截图/下载/登录态);任务级会话隔离、登录态持久化、人机验证识别,纯 `dsh web` 无需桌面外壳即可自托管。
社区评论
评论公开保存在 GitHub Discussions。加载评论会连接 GitHub 和 Giscus;发表内容需要 GitHub 账号。